Lectura completa
La encuesta y la pregunta de la unidad
Tenemos una encuesta real con dos archivos. La planilla Rawdata.xlsx reúne las respuestas de 280 estudiantes de universidades públicas de Malasia. Evaluaron catorce servicios de su campus con notas de 1 a 10. El otro archivo es el cuestionario en PDF que ellos respondieron. Khairunesa Isa publicó ambos en 2020, en Mendeley Data, con licencia CC BY 4.0.
La pregunta de la unidad es simple: qué servicio evalúan mejor los estudiantes. Para responder hay que descargar, entender, limpiar, calcular, comprobar y entregar un informe. Un agente puede ayudar en cada paso. La decisión que practicamos es qué hace el modelo, qué hace un programa y qué decide una persona.
Tres actores en el mismo trabajo
El modelo lee, interpreta y decide la siguiente acción.
Un programa ejecuta reglas explícitas y entrega el mismo resultado cada vez que recibe las mismas entradas.
Una persona define qué cuenta como un resultado correcto y toma las decisiones que cambian el significado de los datos.
La proporción entre los tres cambia según la etapa. Esa es la brújula de esta lectura.
Cómo se reparte el trabajo
En la extracción, el modelo explora las fuentes. Los programas descargan y leen los archivos.
En el procesamiento y el análisis, la persona decide la limpieza y aprueba el plan. Los programas transforman y calculan.
En la reportería, las decisiones ya están escritas en scripts y plantillas. Una rutina puede repetir el trabajo.
Usamos un agente especializado por etapa: con propósito, contexto, herramientas y resultado esperado. Especializar un agente significa escribir esas cuatro piezas en AGENTS.md o en una skill.
Agentes para extracción
El agente de extracción consigue la fuente, saca los datos de su formato original y los guarda en archivos que la siguiente etapa pueda leer. La fuente puede ser un archivo publicado, como la planilla y el cuestionario, o una página web: una ficha con enlace de descarga, una tabla en el HTML, o un listado de muchas fichas.
La decisión principal de esta etapa es qué parte hace el modelo y qué parte hace un programa.
Dos maneras de extraer
Hay dos caminos cuando un agente extrae datos.
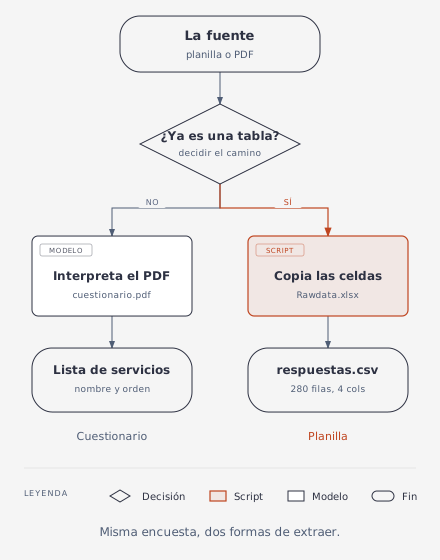
En el primero, le entregamos la fuente al modelo y le pedimos que genere la tabla. El modelo lee, reconoce los datos y los escribe en su respuesta, token por token.
En el segundo, el agente escribe o elige un programa que haga la extracción. El programa copia los datos del archivo a la tabla. El modelo no los reescribe.
La elección depende de cómo está organizada la fuente. La encuesta tiene un caso de cada tipo.
Cuestionario (PDF), extracción con el modelo. El documento combina instrucciones, una escala dibujada y la lista de los catorce servicios. Relacionar cada servicio con su página exige leer e interpretar.
Planilla (Excel), extracción con un programa. Los datos ya están en 280 filas y catorce columnas: 3.920 números. Un programa copia cada celda y entrega el mismo resultado en cada ejecución. Esa operación es determinista: mismas entradas, mismo resultado.
Las columnas que necesitamos
La planilla tiene 22 columnas. Las columnas A a H describen al estudiante, con encabezados en malayo como Jantina (género), umur (edad) y University. Las columnas I a V tienen las notas.
Para comparar biblioteca, centro deportivo y cafetería nos bastan cuatro columnas.
| University (H) | Library (K) | Sport Centre (L) | Cafeteria (T) |
|---|---|---|---|
| UTHM | 8 | 7 | 7 |
| UTHM | 10 | 5 | 3 |
| UTHM | 8 | 8 | 6 |
Toda regla fija que se aplica a muchos datos queda a cargo de un script. Aquí la regla toma las columnas H, K, L y T: 1.120 valores, sin cambiar un dígito.
Pedirle un script y pedir evidencia
Prompt
Convierte la hoja Sheet1 de fuentes/Rawdata.xlsx a datos/respuestas.csv
utilizando un script de Python. Persiste el script. Extrae solamente las
columnas relevantes: University (H), Library (K), Sport Centre (L) y
Cafeteria (T). Muéstrame cuántas filas y columnas leíste y las primeras
cinco filas para ver el resultado.
Le pedimos evidencia que podamos contrastar con el archivo. Si responde 280 filas y 4 columnas, y las filas coinciden con la tabla, la extracción leyó lo que pedimos.
El programa procesa el archivo y le devuelve al modelo solo un resumen. En la encuesta, el modelo recibe el conteo y cinco filas en lugar de las 1.120 notas. Así el contexto se gasta en decidir el siguiente paso, no en reescribir cada celda.
Anthropic describe este patrón en Code execution with MCP: el código filtra y transforma antes de devolverle al modelo lo que necesita revisar.
Navegación automatizada y subagentes
Antes de extraer hay que obtener el archivo. A veces la fuente tiene un enlace de descarga y basta un comando. Otras veces hay que abrir, recorrer o filtrar una página.
Browser use es la capacidad de un agente para operar un navegador: abre una página, lee lo que aparece, hace clic o completa un buscador, y vuelve a leer. La aplicación tiene que ofrecer esa herramienta, o la instalamos. Un ejemplo es agent-browser.
En nuestro caso, el agente puede abrir la ficha en Mendeley Data, reconocer los dos archivos y encontrar sus enlaces de descarga.
Cada vez que el agente lee una página, ese contenido entra a su contexto: menús, botones y texto que no sirven para la tarea. Para cuidar ese contexto, delegamos la navegación a un subagente. Recibe una tarea delimitada, trabaja con su propio contexto y devuelve solo el resultado.
Anthropic usa esta forma en su sistema de investigación con múltiples agentes. En la encuesta, el agente principal recibe solo los dos enlaces.
Prompt
Usa un subagente para abrir la ficha del conjunto en Mendeley Data.
Pídele que encuentre los enlaces de descarga del cuestionario y de la
planilla y que devuelva solo esos dos enlaces.
Crawling
Crawling es el recorrido sistemático de muchas páginas. Si quisiéramos comparar esta encuesta con otras de satisfacción en el mismo repositorio, habría que recorrer resultados, entrar a cada ficha y registrar qué archivos ofrece.
Un crawler necesita tres definiciones antes de empezar: qué enlaces pertenecen a la búsqueda, cómo registra las páginas que ya visitó y en qué momento termina.
Navegar con browser use es lento, porque cada clic pasa por el modelo. Usamos el navegador para entender el patrón de las páginas y le encargamos el recorrido a un script. Si la búsqueda arroja quinientas fichas, un subagente revisa unas pocas y describe el patrón. Con esa descripción, el agente escribe el programa que recorre las quinientas.
Al terminar comparamos cuántas fichas esperábamos con cuántas obtuvimos. Si la búsqueda anunciaba 500 y el archivo tiene 250, el recorrido se cortó a la mitad, aunque cada registro esté correcto.
Shell tools y dónde guardar lo extraído
Las shell tools le permiten al agente pedir la ejecución de comandos en la shell y leer lo que responden. Con ellas puede descargar, correr un script o contar filas.
Esos programas son deterministas. Guardamos el script para poder repetir la extracción y auditarla. Correr dos veces el mismo programa sobre la misma planilla entrega dos archivos respuestas.csv idénticos.
El entorno de ejecución conviene que esté acotado: una carpeta de entrada, una de salida y los accesos justos. Conservamos los originales para comparar después.
El formato de guardado depende de cómo se usarán los datos.
| Formato | Conviene cuando |
|---|---|
| CSV | Queremos que casi cualquier programa o planilla pueda leer la tabla |
| JSON | Un registro trae elementos asociados, como un servicio con su página del cuestionario |
| Excel | Una persona necesita revisar, filtrar o comentar |
| Base de datos | Hay tablas relacionadas o vamos a consultar muchas veces |
Junto a cada extracción guardamos la fuente, la fecha y los criterios usados. Esa procedencia permite volver al archivo que respalda un dato.
Skills para extraer
| Skill | Para qué sirve aquí |
|---|---|
| xlsx | Lee las celdas de la planilla con un programa |
| Saca el texto del cuestionario; el modelo sigue interpretando escala y orden | |
| agent-browser | Abre la ficha y encuentra los enlaces de descarga |
| firecrawl-scrape | Devuelve el texto de una URL cuando el contenido ya está en el HTML |
| firecrawl-crawl | Recorre muchas páginas de un mismo sitio |
La skill entrega la capacidad. El agente decide cuándo usarla.
Agentes para procesamiento y análisis
Con los datos extraídos, armamos un agente de procesamiento y análisis para limpiar, transformar, calcular y revisar los resultados.
Limpieza supervisada
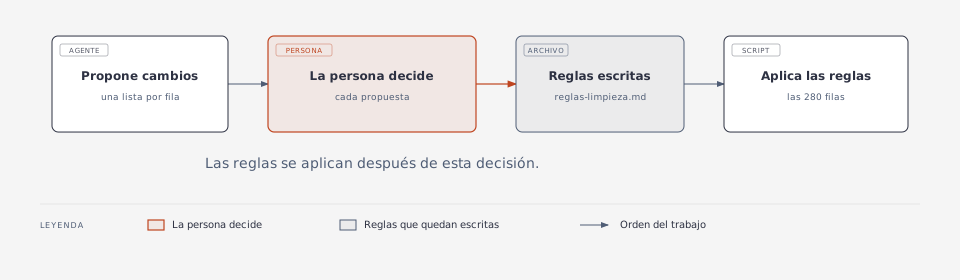
Le pedimos al agente que revise los archivos y proponga cambios sin aplicarlos.
Prompt
Revisa fuentes/Rawdata.xlsx, datos/respuestas.csv y
fuentes/cuestionario.pdf. Lista, por fila, el problema que encuentres, el cambio
que propones junto a su efecto en los datos, y una columna vacía para yo tomar
una decisión. No modifiques ningún archivo hasta que apruebe la lista.
La persona decide. Recién entonces las reglas aprobadas quedan escritas, por ejemplo en reglas-limpieza.md.
En la encuesta, la lista del agente y nuestras decisiones quedarían así.
| Problema | Propuesta | Decisión |
|---|---|---|
| "UTHM" y "Uthm", "USIM" y "Usim" | Unificar en mayúsculas | Se acepta |
| Encabezados con espacios de más | Recortar espacios | Se acepta |
| La columna R no tiene nombre | Llamarla "Parking lot" | Queda pendiente |
| El PDF dice 10 como "very dissatisfied" | Leer 1 insatisfecho y 10 satisfecho | Se acepta: la escala dibujada y Mendeley coinciden |
Esta forma de trabajar se llama limpieza supervisada. Es un caso de Human-in-the-loop: una persona participa en las decisiones del proceso. El agente inspecciona y propone. La persona decide. Las reglas aprobadas quedan en el proyecto, con frases como "unificar los nombres de universidad en mayúsculas".
Transformación con scripts
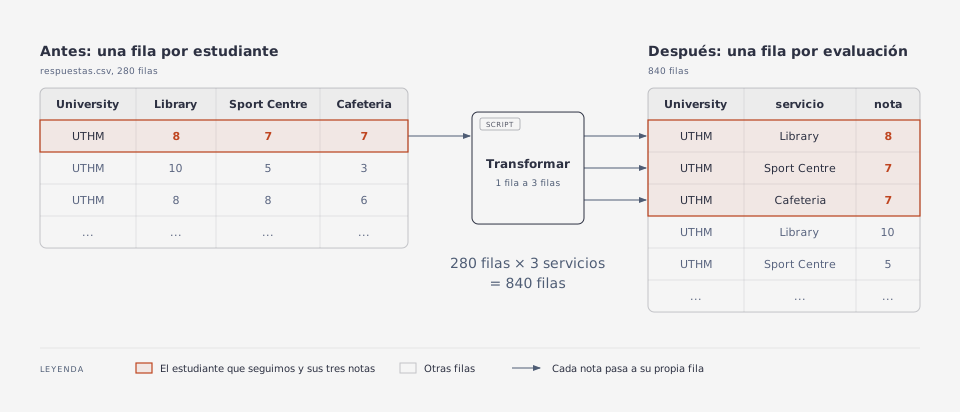
Las reglas aprobadas las aplica un script. En la encuesta, normaliza los nombres de universidad: "Uthm" pasa a "UTHM" y "Usim" pasa a "USIM".
El mismo programa transforma la tabla a una fila por evaluación. Pasamos de una fila por estudiante, con tres columnas de notas, a una fila por servicio y nota. Así, un mismo cálculo agrupado por servicio entrega los resultados de biblioteca, centro deportivo y cafetería.
Planificación supervisada
Antes de calcular, le pedimos un plan. El plan fija qué se calcula, con qué datos y cómo se comprueba.
Prompt
Antes de calcular, escribe un plan con las preguntas que vas a responder,
las columnas que vas a usar, las operaciones y cómo vas a comprobar cada
resultado. No ejecutes nada hasta que lo apruebe.
Revisar ese plan es el segundo lugar donde la persona interviene. Cursor y Claude Code tienen un modo Plan que funciona así. Anthropic describe agentes que se detienen a pedir retroalimentación en puntos de control.
La pregunta es qué servicio evalúan mejor los estudiantes. Definimos las medidas antes de mirar los datos. Una escala de 1 a 10. El promedio resume el nivel general. La mediana muestra el valor central. La distribución muestra si las opiniones están concentradas o divididas.
Un servicio con promedio 6 puede tener a casi todos en 6, o a la mitad en 2 y la otra mitad en 10. Por eso el plan calcula las tres. Las columnas son K, L y T, con sus 280 respuestas. La columna R no aparece: quedó pendiente en la limpieza. Cada operación informa cuántos valores usó.
Un subagente que verifica
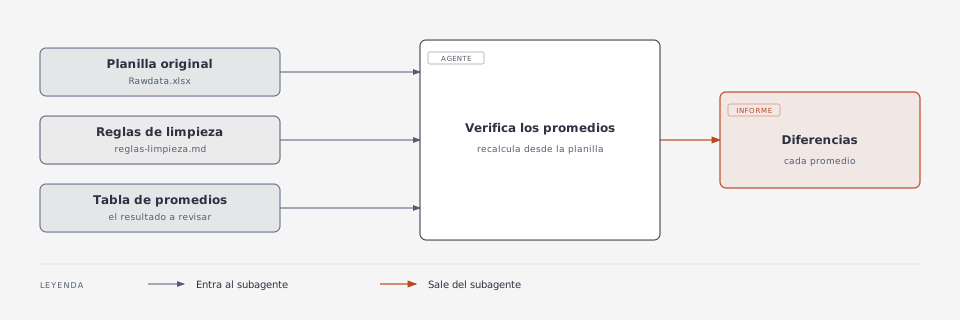
La verificación puede quedar a cargo de un subagente. Recibe las fuentes y los criterios, sin las conclusiones del primer agente.
Prompt
Usa un subagente para verificar los promedios. Entrégale
fuentes/Rawdata.xlsx, reglas-limpieza.md y la tabla de promedios, sin
las conclusiones del informe. Pídele que recalcule cada promedio desde
el archivo original y que reporte cualquier diferencia.
Si el subagente solo confirma lo que ya se concluyó, aporta poco. Por eso recalcula desde la planilla y las reglas, no desde el texto del informe.
Skills para procesar y analizar
| Skill | Para qué sirve aquí |
|---|---|
| xlsx | Unifica textos, recorta espacios y arma columnas |
| explore-data | Revisa filas, vacíos, duplicados y valores raros |
| statistical-analysis | Calcula promedio, mediana, distribución y extremos |
| validate-data | Revisa método, cuentas y si la conclusión sale de la tabla |
| sql-queries | Agrupa y filtra cuando los datos están en una base |
La persona sigue aprobando qué cambio se aplica y qué plan se ejecuta.
Agentes para visualización
El agente de visualización produce gráficos, tableros e informes a partir de los archivos del análisis. Las decisiones sobre los datos ya están escritas.
Un Canvas es un espacio al lado de la conversación, donde el agente construye una vista que podemos seguir ajustando.
Un dashboard en HTML reúne indicadores y gráficos. Puede incluir filtros, por ejemplo para ver una sola universidad.
Una infografía muestra hallazgos para que alguien los lea en un documento o un afiche.
Un equipo que monitorea estos datos necesita filtrar por universidad: le sirve un dashboard. Un estudiante que ve un afiche necesita el resultado principal: le sirve una infografía. Cuando estamos trabajando sobre los datos y queremos probar vistas al tiro, conviene el Canvas.
La cifra sale de la tabla del análisis. El agente elige cómo mostrarla. Nosotros comprobamos que el gráfico diga lo mismo que la tabla.
Skills para visualizar
| Skill | Para qué sirve aquí |
|---|---|
| data-visualization | Elige el gráfico según los datos y lo escribe en Python |
| build-dashboard | Arma un tablero en HTML, con gráficos, tablas y filtros |
| chart-visualization | Ayuda a elegir el tipo de gráfico antes de dibujarlo |
| baoyu-infographic | Genera un afiche. Las cifras se copian de la tabla |
| canvas-design | Compone una pieza estática, en PNG o PDF |
Agentes para reportería
El resultado final suele ser un documento: un informe en Word, una presentación o un PDF.
Una skill para documentos empaqueta instrucciones, plantillas y scripts que construyen el archivo con un procedimiento fijo. Anthropic publica skills de este tipo para Word, PowerPoint, Excel y PDF.
El agente redacta la interpretación y decide qué tabla o gráfico acompaña cada sección. El script arma el documento a partir de la plantilla. Con los mismos datos y la misma plantilla obtenemos los mismos estilos, la misma numeración y las tablas en el mismo lugar.
Si el informe tiene tres secciones, una por servicio, cada una trae la misma tabla: promedio, mediana y distribución de las 280 respuestas. El script llena esas tablas desde los archivos del análisis. Las cifras se actualizan cuando se actualizan los datos. La interpretación la escribe el modelo. Si el informe dice que un servicio es el mejor evaluado, comprobamos que la tabla de promedios y la distribución digan lo mismo.
Un playbook para repetir el semestre
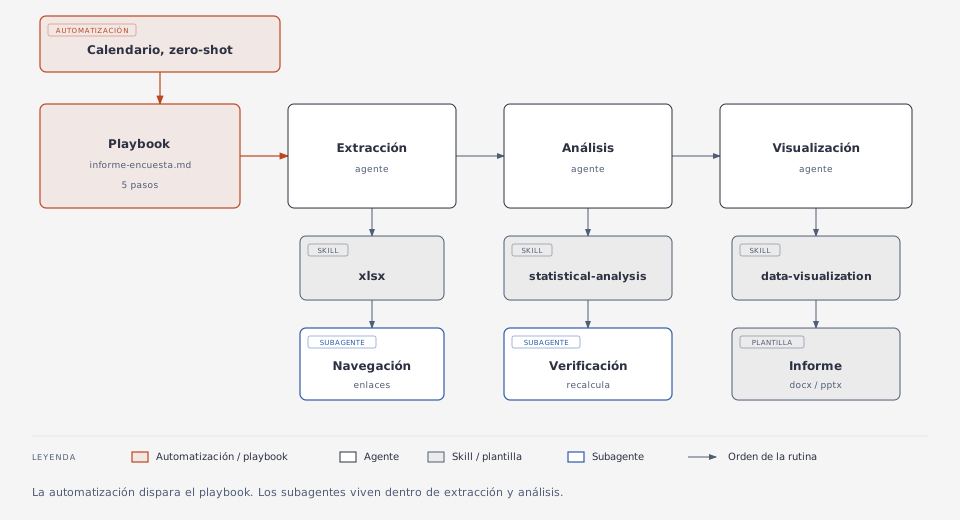
Ese encadenamiento se escribe en un playbook. Puede vivir en playbooks/informe-encuesta.md o en la configuración de la automatización. En la encuesta, el playbook tendría cinco pasos.
- Descargar los archivos nuevos y guardarlos con fecha junto a los anteriores.
- Aplicar las reglas de
reglas-limpieza.md. - Calcular las estadísticas definidas.
- Generar los gráficos.
- Armar el informe con la plantilla.
Cada etapa indica qué debe hacer y qué skill corresponde.
Automatización zero-shot
Una automatización ejecuta tareas según un calendario, por ejemplo el primer lunes de cada mes a las 8:00. Varias aplicaciones lo ofrecen como schedules, automatizaciones o rutinas.
En esta etapa la rutina corre sola. Las decisiones que necesitaban criterio humano ya están escritas como reglas, scripts y plantillas. Esa rutina es zero-shot: toma los archivos del semestre y entrega el informe completo en una sola pasada.
La automatización dispara el playbook. En extracción y análisis entran subagentes. En visualización, la plantilla arma el informe.
Reproducibilidad
Con los mismos datos y el mismo procedimiento obtenemos el mismo resultado. Cualquier diferencia entre dos informes se explica por un cambio en los datos o en las reglas.
Para lograrlo guardamos con fecha cada descarga y mantenemos un historial de los scripts, las reglas y las plantillas. Si alguien cuestiona el informe de un semestre, tomamos la descarga de esa fecha y la versión de los scripts de ese momento, volvemos a generar el informe y revisamos cada paso.
Skills para reportar y automatizar
| Skill | Para qué sirve aquí |
|---|---|
| docx | Arma el informe en Word a partir de una plantilla |
| pptx | Arma la presentación con el mismo procedimiento |
| Arma un PDF con un procedimiento fijo | |
| cli-for-agents | Diseña comandos que corran solos, sin preguntas en el medio |
| show-me-your-work | Deja registro de cada decisión: qué se hizo, por qué y con qué evidencia |
Resumen
El reparto por etapa
| Etapa | El modelo | Los programas | La persona |
|---|---|---|---|
| Extracción | Explora fuentes nuevas y decide cómo leerlas | Descargan, recorren y extraen con reglas fijas | Define el alcance y revisa el programa |
| Procesamiento y análisis | Detecta problemas, propone cambios y presenta un plan | Transforman y calculan con las reglas acordadas | Decide la limpieza y aprueba el plan |
| Visualización y reportería | Elige la vista, acompaña cada sección y redacta | Generan gráficos e informes; la rutina los repite | Diseñó la rutina y la deja correr |
La regla práctica
Escribimos cada decisión que tomamos: una regla de procesamiento, un script o una plantilla. El agente la aplica igual cada vez.
La rutina sin supervisión se arma al final. En la encuesta, la automatización llega cuando las reglas de limpieza, el script de estadísticas y la plantilla del informe ya están creados, revisados y listos. Un agente especializado no adivina el criterio. Aplica el criterio que ya acordamos.