Lectura completa
Redacción académica: qué podemos automatizar y dónde está el trabajo humano
Cuando preparamos un informe, una revisión bibliográfica o una tesis, no todas las etapas del escrito tienen la misma naturaleza. Algunas tareas siguen reglas mecánicas y repetibles, otras se benefician del diálogo con un asistente o un agente para destrabar un borrador, y otras exigen juicio propio y responsabilidad intelectual. Redactar con herramientas de inteligencia artificial consiste en repartir el trabajo con criterio antes de empezar a escribir.
Antes de revisar la clasificación, piensa en un informe académico de tu carrera y anota mentalmente o en tu cuaderno: ¿qué partes le encargarías a un agente y cuáles reservarías íntegramente para ti? Contrastar esa intuición inicial con las tres categorías siguientes permite trazar una frontera clara.
Tres tipos de tarea en un escrito académico
Podemos agrupar las tareas de la escritura académica en tres niveles según el grado de delegación y el tipo de decisión que involucran:
- Automatizable: tareas mecánicas gobernadas por reglas explícitas, donde no se altera el fondo intelectual del argumento. Incluye dar formato al documento y a las referencias bibliográficas, resumir una fuente individual para ficharla, revisar la consistencia interna de términos o siglas a lo largo de los capítulos y traducir pasajes.
- Asistido: tareas donde el agente actúa como apoyo para organizar material o explorar redacciones posibles, siempre bajo la conducción del autor. Incluye proponer la estructura de una sección, apoyar en la síntesis y búsqueda de fuentes, organizar el análisis preliminar y redactar borradores que luego serán editados.
- Humano: decisiones intelectuales que definen el valor y la veracidad de la obra. Aquí viven la pregunta de investigación, el pensamiento crítico, el juicio sobre la evidencia, el cruce de hallazgos, el armado de conclusiones y, por sobre todo, la autoría y la responsabilidad frente a lo que se firma.
| Categoría | Rol del agente y del autor | Tareas representativas |
|---|---|---|
| Automatizable | El agente o un script aplica reglas fijas de forma repetible. | Formato y estilo de citas, resumen de una fuente individual, consistencia terminológica, traducción. |
| Asistido | El agente propone opciones o borradores; la persona dirige, filtra y edita. | Estructura del texto, búsqueda y síntesis preliminar de fuentes, apoyo al análisis, redacción de borradores. |
| Humano | Indelegable: recae íntegramente en quien investiga y firma. | Pregunta de investigación, pensamiento crítico, juicio sobre qué es verdad, cruce de resultados, conclusiones y autoría. |
El reparto sobre un paper publicado
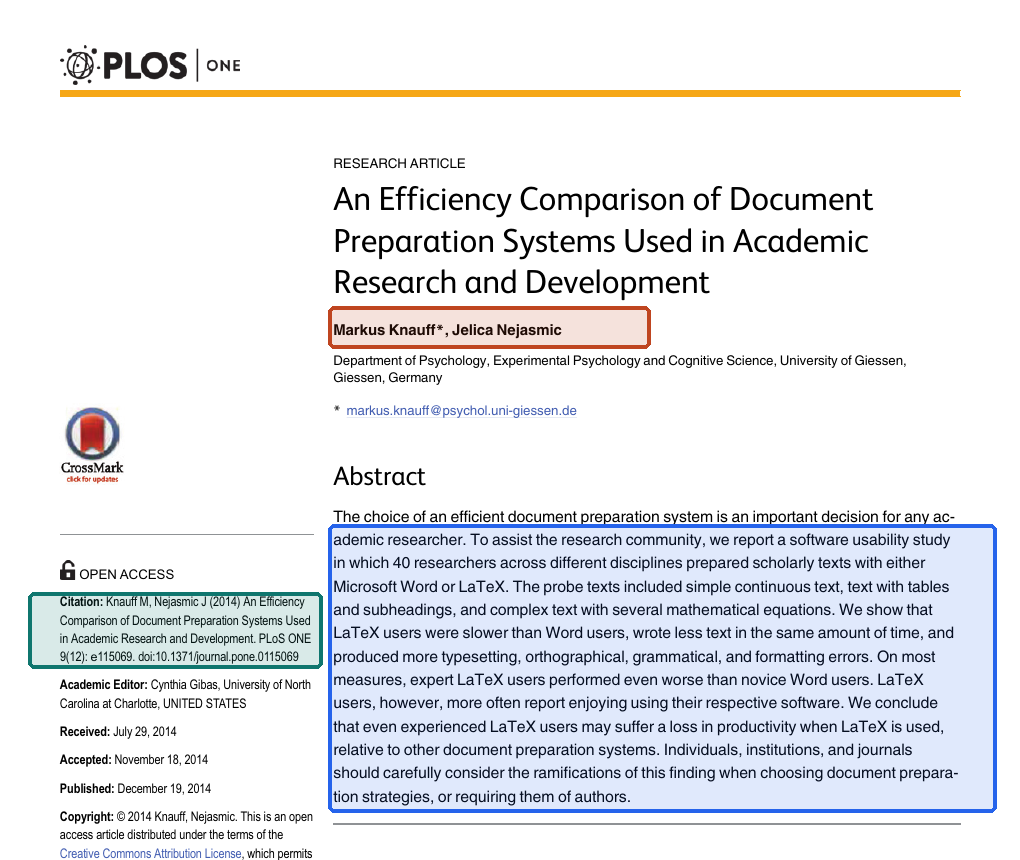
Para observar esta distinción fuera de una lista abstracta, miremos dos páginas de un artículo real publicado por Markus Knauff y Jelica Nejasmic (2014) en PLOS ONE bajo licencia CC BY 4.0. Más allá del tema puntual del estudio, sus secciones muestran con nitidez dónde entra cada tipo de tarea.
En la primera página conviven una tarea automatizable y una tarea asistida. Al margen izquierdo aparece la cita bibliográfica ya formateada según la norma de la revista: comprobar o transformar ese formato es una labor mecánica e ideal para automatizar. En el centro aparece el abstract o resumen ejecutivo: un agente puede ayudar a redactar un primer borrador a partir de las secciones del manuscrito, pero el autor sigue revisando cada frase.
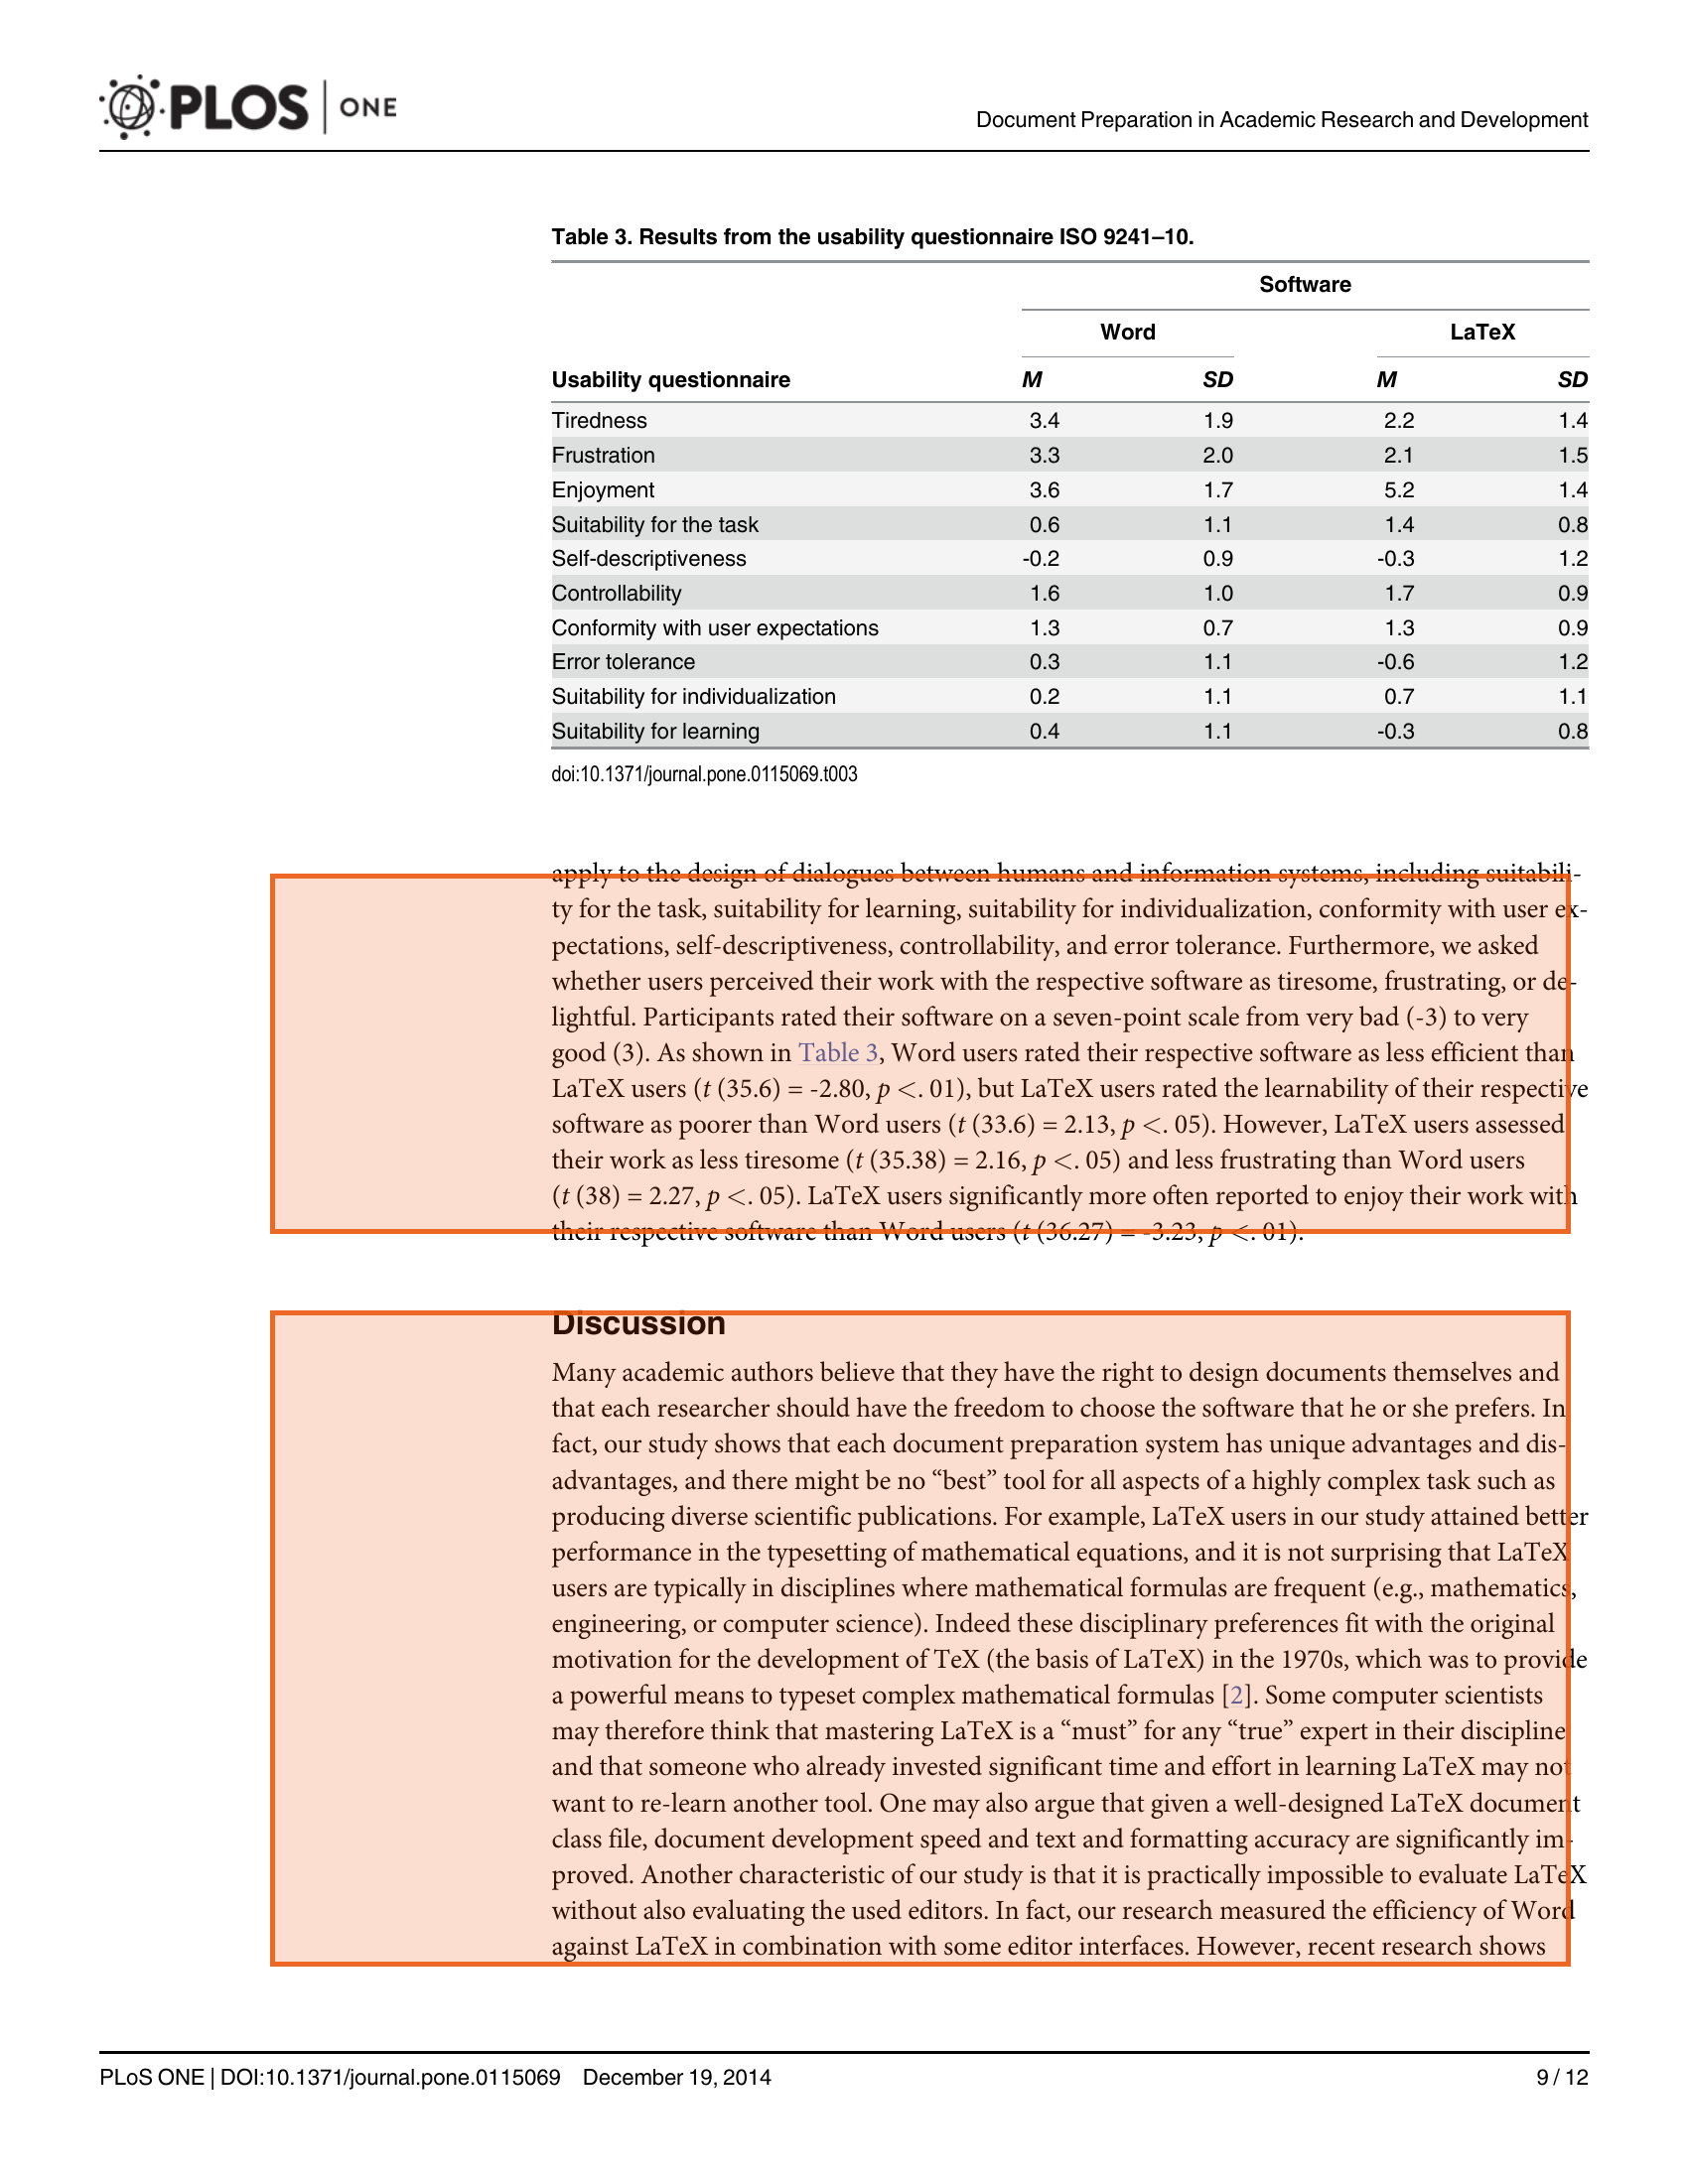
Cuando avanzamos al cuerpo del artículo, en la sección de discusión (página 9), aparece el trabajo que pertenece exclusivamente al investigador. Allí los autores cruzan información proveniente de distintas mediciones del estudio y arman las conclusiones defendiendo qué significan esos datos y qué límites tienen. Ese juicio interpretativo no se delega en el modelo.
Skills de redacción
Si ya sabemos qué partes del escrito vamos a trabajar de forma asistida, el paso siguiente es preguntarnos con qué herramientas guiamos al agente para que respete los estándares de nuestra disciplina. Aquí entran las skills de redacción.
Definición: normas dejadas por escrito para el agente
Las skills de redacción son archivos de instrucciones que definen las normas de buena escritura de un género o disciplina para que el agente las consulte al redactar. Funcionan como un acuerdo de estilo reutilizable: de esta manera, en cada sesión de trabajo el criterio de redacción se mantiene constante sin tener que explicarlo desde cero en cada prompt.
Una skill de redacción académica puede dejar por escrito cuatro dimensiones principales:
- Tono: cómo debe sonar el texto en ese género específico, cuidando un registro formal, técnico y acorde con las convenciones de la disciplina.
- Estructura: el esqueleto esperado del documento. En ciencias empíricas suele seguir el formato IMRyD (Introducción, Métodos, Resultados y Discusión), mientras que en derecho, humanidades o ensayos argumentativos adopta otras formas.
- Afirmaciones: cuándo afirmar con fuerza, cuándo matizar un hallazgo según el alcance de los datos y qué evidencia debe acompañar a cada oración.
- Citación: qué norma bibliográfica exige la carrera o revista (APA, IEEE, Vancouver, Chicago) y qué elementos deben quedar registrados en la declaración de uso de IA.
El agente aplica estas reglas de forma consistente al proponer o revisar párrafos, pero quien decide el contenido y el sentido del texto a grandes rasgos sigue siendo el autor.
Skills académicas en skills.sh
En el catálogo público de skills.sh existen múltiples skills creadas por terceros para apoyar distintas etapas del trabajo académico. Cinco ejemplos representativos muestran cómo se especializan estas capacidades:
- nature-citation: sugiere citas pertinentes y mapea cada afirmación del texto con la fuente que la respalda.
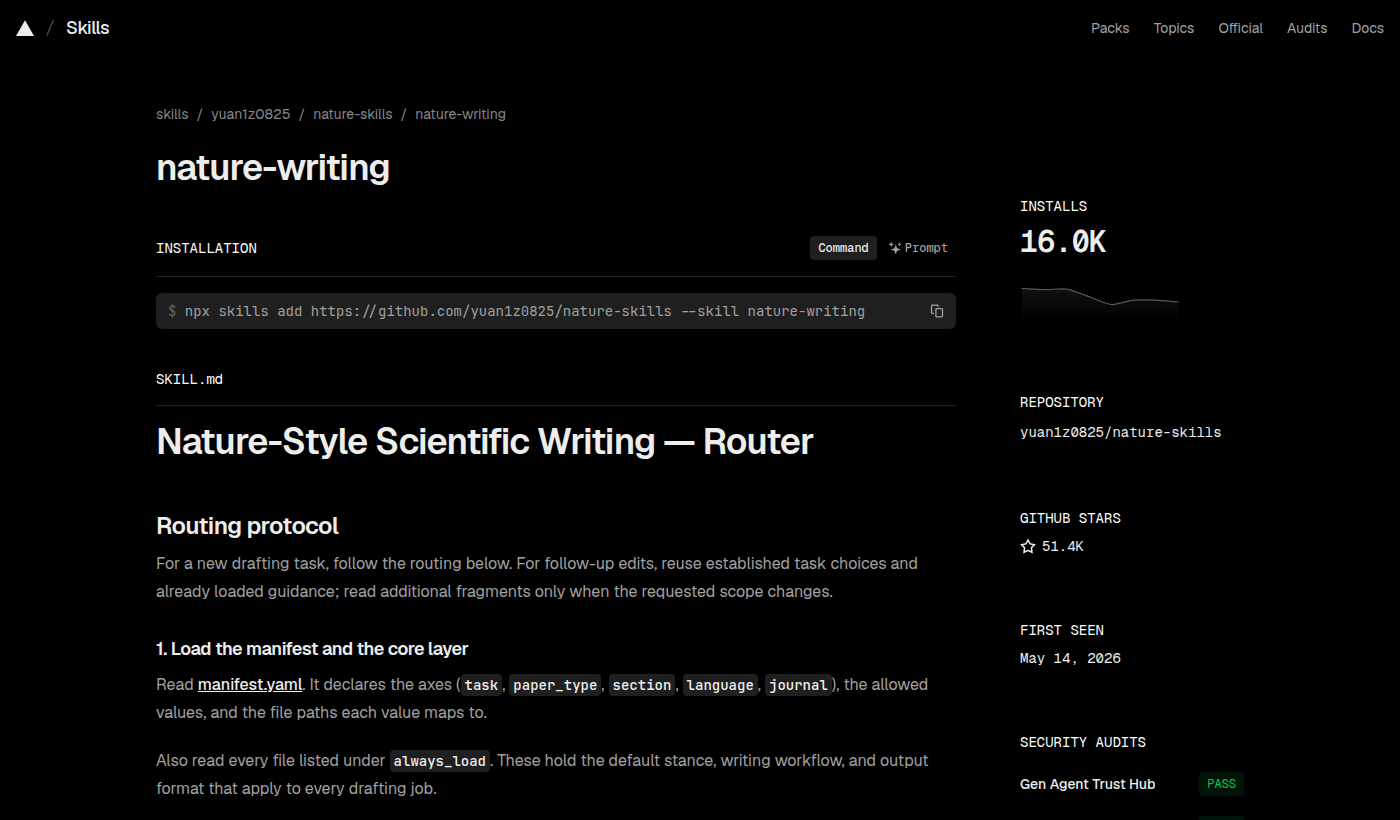
- nature-writing: reestructura el manuscrito y su flujo narrativo a partir de la evidencia proporcionada por el autor.
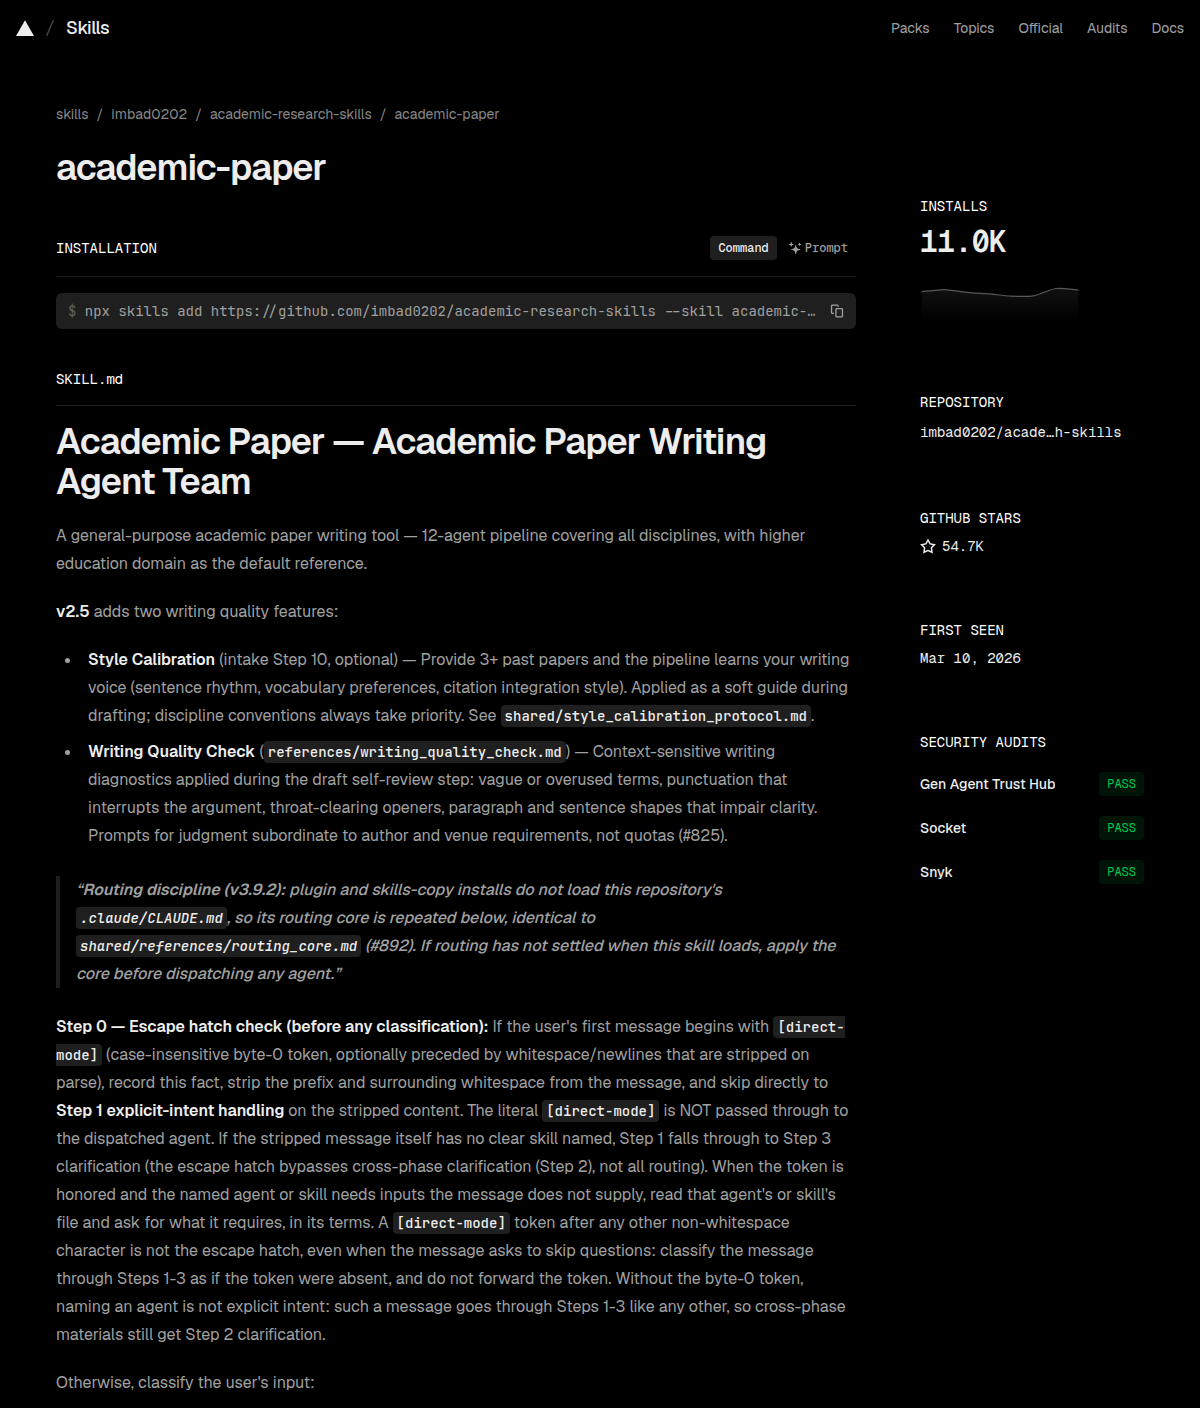
- academic-paper: pipeline completo para escribir un artículo académico, incluyendo modos de chequeo de citas y declaración de uso de IA.
- academic-writing: organiza roles de autoría (taxonomía CRediT), identificadores ORCID y la declaración de uso de herramientas generativas.
- literature-search-openalex (Google DeepMind): consulta directamente la base de datos académica OpenAlex en lugar de depender de la memoria paramétrica del modelo.
Qué incluye por dentro una skill como academic-paper
Al inspeccionar la documentación de academic-paper en skills.sh, vemos cómo un equipo organiza un flujo complejo en un archivo SKILL.md:
- Pipeline de 12 agentes: cubre la escritura de artículos en distintas disciplinas, tomando educación superior como referencia por defecto.
- 11 modos de operación: permite trabajar sobre el plan, el esquema (outline), la revisión de un borrador, la respuesta a revisores, el abstract, la revisión de literatura, el chequeo de citas y la declaración de uso de IA.
- Calibración de estilo (opcional): si el autor entrega 3 o más artículos propios anteriores, la skill analiza el ritmo de las oraciones y el vocabulario preferido para mantener su voz al redactar.
- Chequeo de calidad de escritura: aplica diagnósticos durante la autorrevisión del borrador para detectar términos vagos, muletillas al inicio de los párrafos y estructuras que restan claridad.
Precaución antes de instalar skills de terceros
Todas estas capacidades provienen de repositorios externos publicados por la comunidad. Como vimos al estudiar agentes locales, instalar una skill incorpora instrucciones y posibles programas a tu entorno de trabajo. Por eso rige una regla estricta: antes de ejecutar el comando de instalación de una skill de terceros, lee siempre su archivo SKILL.md y revisa todos sus scripts para verificar qué órdenes le da al modelo y qué código ejecuta en tu computador.
Citación responsable: transparencia y rigor en el uso de IA
Contar con skills que estructuran un borrador o sugieren referencias no resuelve por sí solo la validez de un texto. La credibilidad de cualquier trabajo académico o profesional descansa sobre dos compromisos que ningún sistema automatizado puede asumir por nosotros: verificar las fuentes y afirmaciones y declarar con transparencia cómo se utilizó la IA.
Verificar fuentes y afirmaciones: la veracidad está en manos de quien firma
Todo trabajo académico exige comprobar dos certezas frente a cada cita bibliográfica: primero, que la fuente exista realmente (que no sea una referencia alucinada con título verosímil y autores mezclados); y segundo, que el documento original respalde con exactitud lo que se afirma en nuestro párrafo.
Un modelo de lenguaje puede sugerir citas con un formato impecable o redactar con aparente seguridad, pero opera por probabilidad estadística sobre secuencias de tokens y carece de juicio sobre la realidad de los hechos. Incluso cuando el artículo citado existe y tiene un DOI válido, el modelo puede atribuirle una conclusión exagerada o distinta de la que midieron sus autores.
Verificar cada referencia contra el documento original permite contrastar la evidencia y sostener la confianza del lector. Una sola cita inventada o tergiversada derrumba la credibilidad de todo el escrito. Quien firma el documento responde por cada línea publicada: comprobar las fuentes contra el texto primario es siempre tarea indelegable del autor.
Declaración de uso de IA: honestidad académica y autoría
Hoy los modelos generativos asisten de forma cotidiana en tareas como estructurar ideas, explorar literatura y pulir el estilo de un borrador. Utilizar estas herramientas como apoyo intelectual es legítimo cuando está permitido por el curso o la publicación y se transparenta con honestidad.
- Por qué importa declarar: resguarda la confianza académica, permite a los lectores y evaluadores distinguir y valorar el aporte original de los autores, favorece la reproducibilidad del proceso y asegura la integridad del trabajo conforme a los Lineamientos UC para el uso de IA en la formación.
- Qué entendemos por citación responsable de IA: es la práctica explícita de dejar por escrito qué herramienta y versión se utilizó, en qué tareas intervino como apoyo, qué etapas realizó exclusivamente el autor y quién verificó las fuentes y el contenido final.
En este marco, la IA actúa únicamente como herramienta de asistencia. Un modelo no tiene agencia moral ni legal, por lo que no puede figurar como coautor; la autoría y la responsabilidad ética recaen siempre en las personas.
Ejemplo de declaración de uso de IA
A continuación se presenta un modelo de declaración aplicable a informes universitarios, tesis y manuscritos académicos. Puedes adaptarlo según las herramientas y etapas de tu propio proyecto:
Ejemplo de declaración de uso de IA
Declaración de uso de IA:
"Durante este trabajo utilizamos Claude 3.7 Sonnet y Cursor para estructurar el esquema inicial y revisar la redacción de la introducción. El diseño metodológico, el análisis de datos y las conclusiones fueron realizados íntegramente por los autores. Todas las fuentes fueron verificadas contra sus textos originales, y asumimos plena responsabilidad por el manuscrito final."
Observa los tres componentes que hacen completa y verificable esta declaración:
- Herramientas: indica el nombre y la versión o entorno específico utilizado (en lugar de una mención vaga a "inteligencia artificial").
- Alcance: delimita con claridad qué tareas apoyó la IA (esquema inicial y revisión de redacción en la introducción) y cuáles ejecutó íntegramente el equipo humano (diseño metodológico, análisis y conclusiones).
- Responsabilidad: deja constancia de que todas las fuentes bibliográficas fueron verificadas contra sus textos originales y ratifica la firma y responsabilidad humana sobre el texto final.
Deep research: plan, búsqueda en paralelo e informe con citas
Cuando combinamos planificación, búsqueda con subagentes, filtrado de fuentes y redacción con referencias, obtenemos el patrón conocido como deep research (investigación profunda). Se trata de un sistema agéntico que investiga una pregunta abierta a lo largo de varias rondas y entrega un informe estructurado con citas.
Cómo funciona un deep research por dentro
En lugar de responder de inmediato con una sola consulta, un flujo de deep research coordina distintos roles alrededor de un plan:
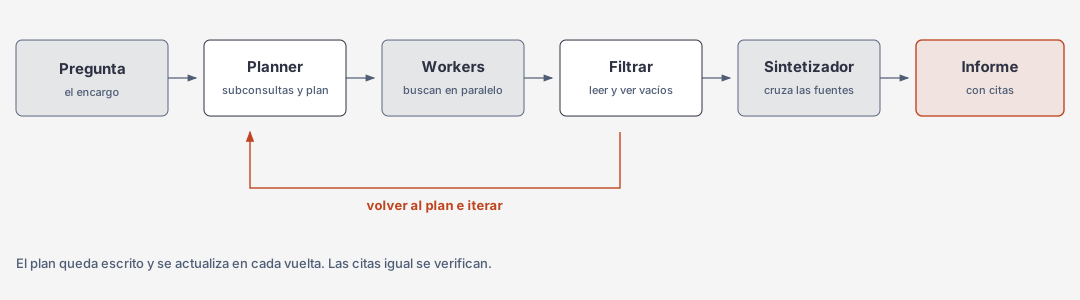
- Pregunta y Planner: el agente planificador recibe el encargo, lo descompone en subconsultas específicas y deja escrito un plan de investigación.
- Workers en paralelo: varios subagentes exploran distintas fuentes al mismo tiempo, cada uno con su propio contexto acotado para no saturar la ventana principal.
- Filtrar y detectar vacíos: se evalúa la relevancia de lo encontrado y se identifican preguntas que aún no tienen respaldo suficiente. Esa revisión alimenta una vuelta al plan para lanzar nuevas búsquedas focalizadas.
- Sintetizador e informe con citas: una vez reunida la evidencia, el sintetizador cruza los hallazgos de las fuentes seleccionadas y redacta el informe final vinculando cada afirmación con su referencia.
El plan se reescribe en cada vuelta
El corazón de un deep research es que el documento del plan actúa como centro del flujo. Siguiendo la misma lógica de manejo de contexto que hemos estudiado en el curso, el agente repite un ciclo de tres pasos:
- Escribir: deja por escrito el plan inicial con las preguntas y líneas que va a profundizar.
- Profundizar: ejecuta las búsquedas en paralelo, lee los documentos recuperados y filtra qué sirve y qué falta.
- Volver: actualiza el documento del plan con lo aprendido y abre otra vuelta de búsqueda hasta cubrir los vacíos.
Aunque el deep research automatiza la exploración en varias rondas y entrega un texto muy articulado, aplica exactamente la misma regla de la sección anterior: sus citas y sus conclusiones igual deben ser verificadas por la persona que firma.
Multimodalidad: mismo modelo, otras entradas y salidas
Hasta este punto del curso hemos trabajado casi exclusivamente con texto (incluso cuando leíamos archivos PDF o planillas, los convertíamos en palabras y tablas de texto). Sin embargo, los modelos actuales también pueden recibir y producir otras modalidades. Decimos que un sistema es multimodal cuando su contexto de entrada o su generación de salida incluye imágenes, audio o video, además de texto.
Para recorrer cómo procesa un modelo estas modalidades sin cambiar su principio de funcionamiento, usaremos como hilo conductor la fotografía de este pug:
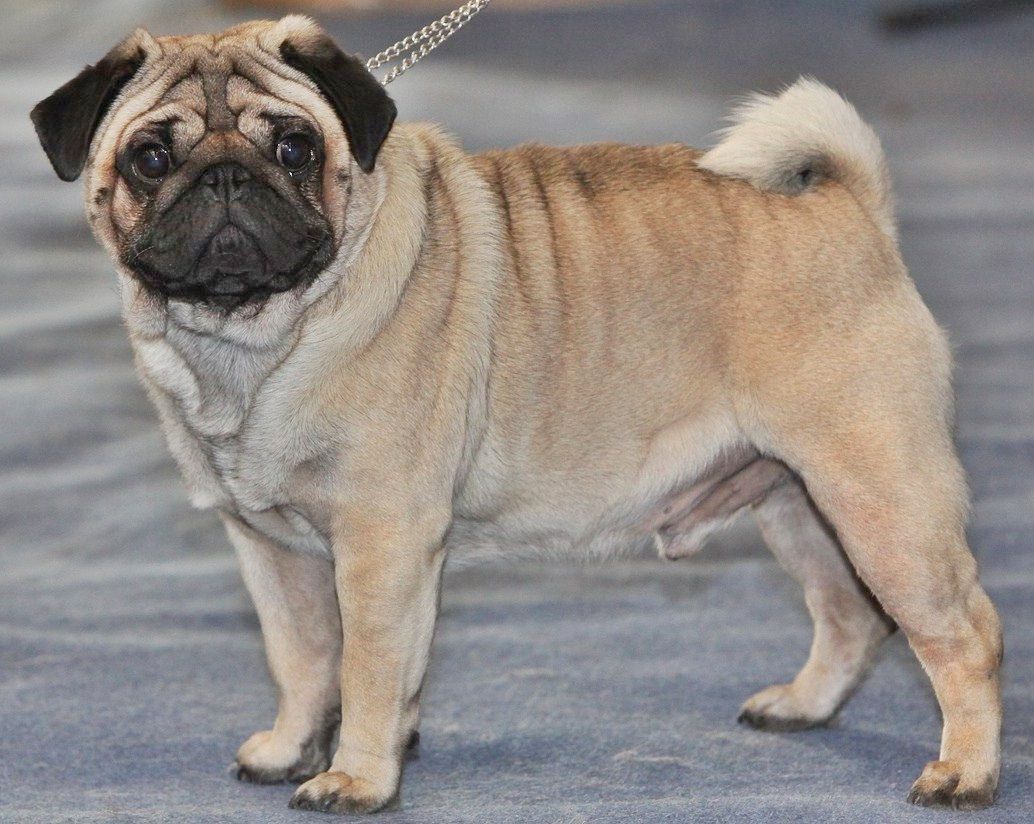
Imagen: parches, vectores y flujo completo
Cuando estudiamos los modelos de lenguaje en las primeras clases, vimos que el texto no entra al modelo como letras sueltas, sino cortado en tokens que se transforman en vectores numéricos. Con una imagen ocurre un proceso equivalente: para el modelo, una imagen es una secuencia de parches convertidos en vectores.
De la foto a los parches (capa de entrada)
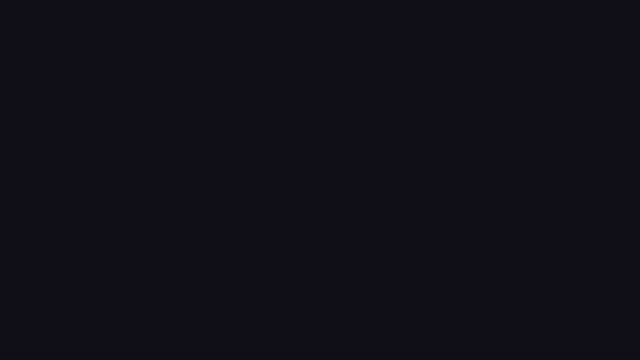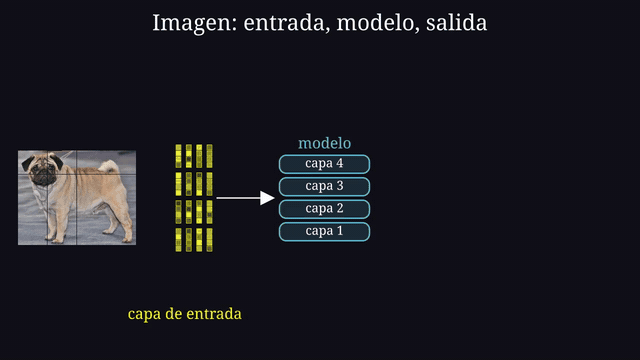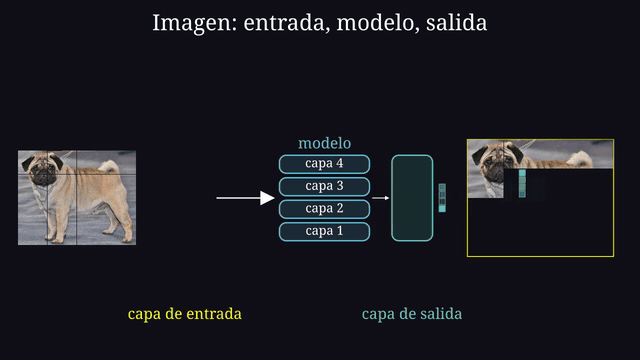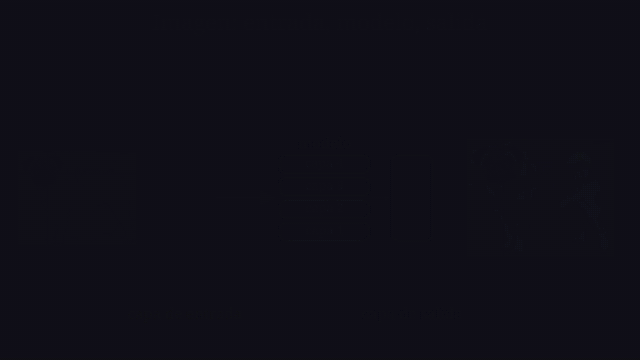
Al recibir una fotografía, la capa de entrada (el tokenizador o encoder visual) la divide en una cuadrícula de pequeños recuadros llamados parches (patches). En la siguiente animación simplificada, la foto del pug se corta en 16 parches que equivalen a 16 tokens visuales (en un modelo real, la cuadrícula es mucho más fina y abarca cientos o miles de parches):
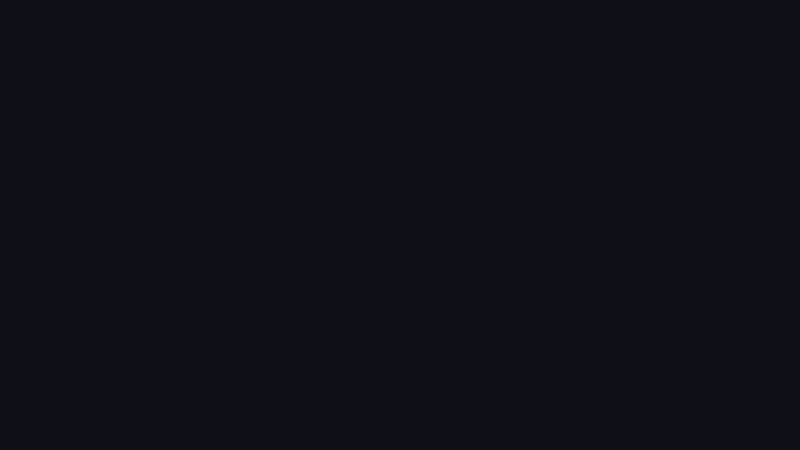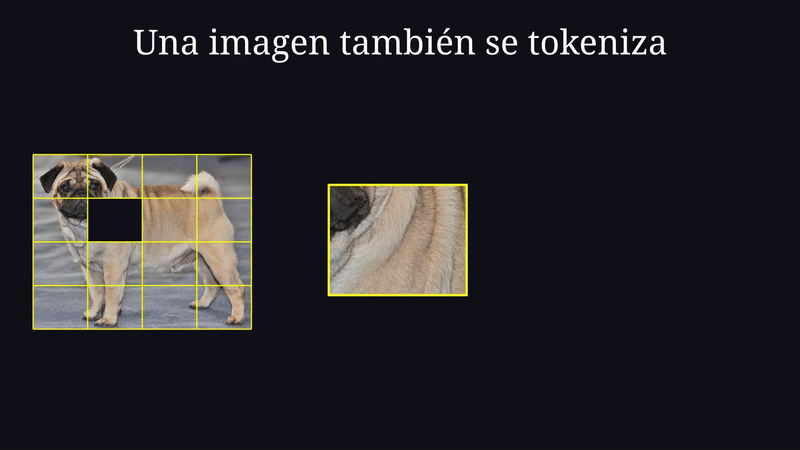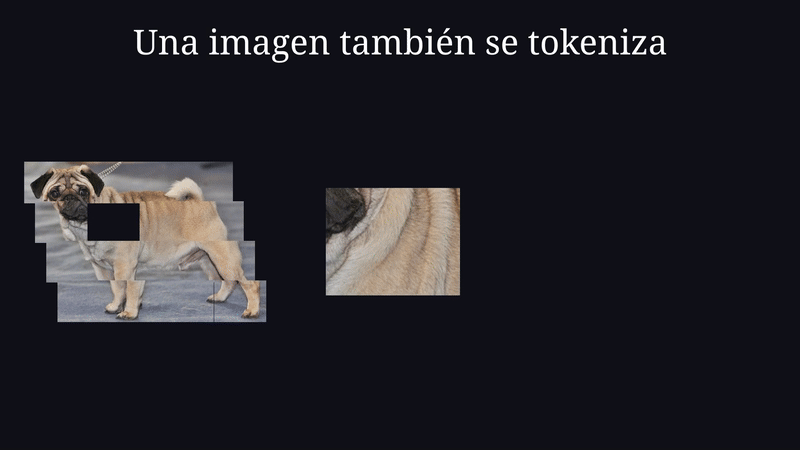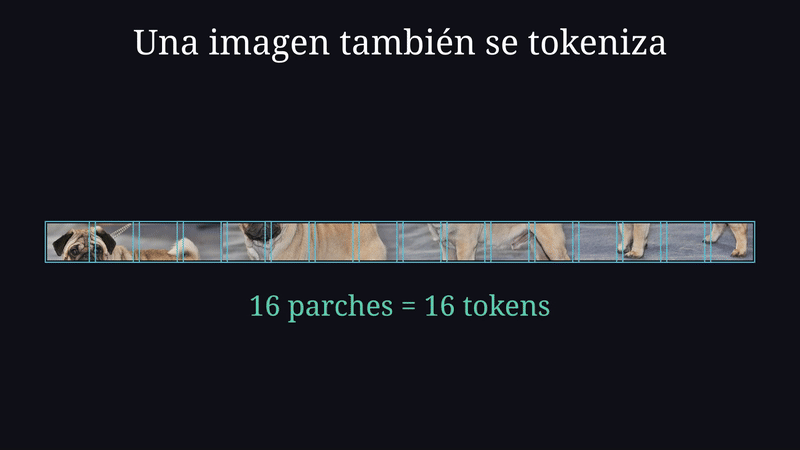
Cada parche se transforma en un vector (un embedding) dentro del mismo espacio matemático que los tokens de texto. Gracias a eso, los vectores de la imagen se ponen en fila junto a los vectores de las palabras de tu instrucción, y las capas internas del modelo ajustan sus probabilidades considerando ambas fuentes a la vez. Algunos modelos parten entrenados solo con texto y luego se adaptan para recibir imágenes (como LLaVA), pero el patrón habitual hoy es entrenar el modelo con múltiples modalidades desde el principio para que sus pesos comprendan nativamente esos vectores.
El modelo del medio es el mismo: cambian la entrada y la salida
Si tanto el texto como la imagen y el audio se transforman en secuencias de vectores, ¿qué cambia en la arquitectura para pasar de un modelo de texto a uno multimodal? Solo cambian los extremos:
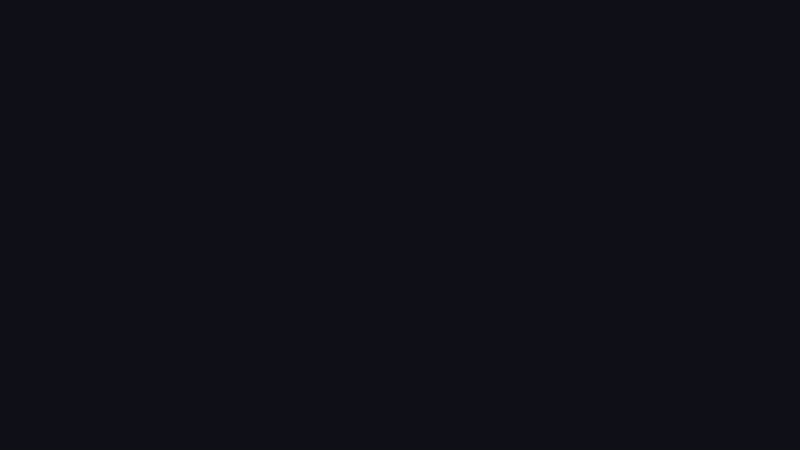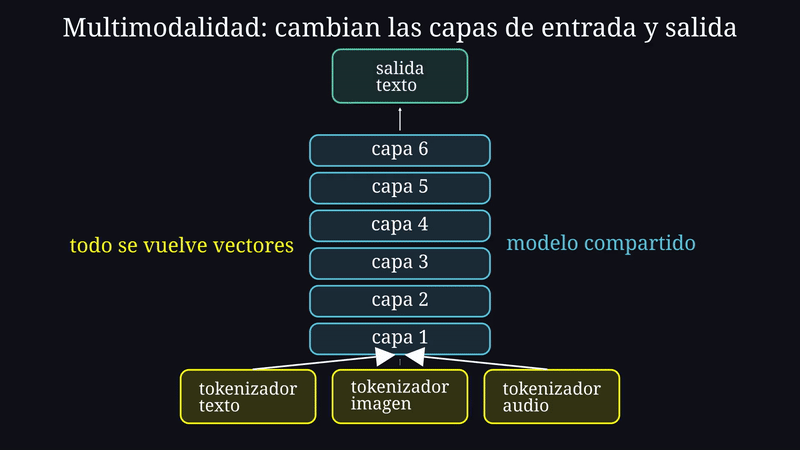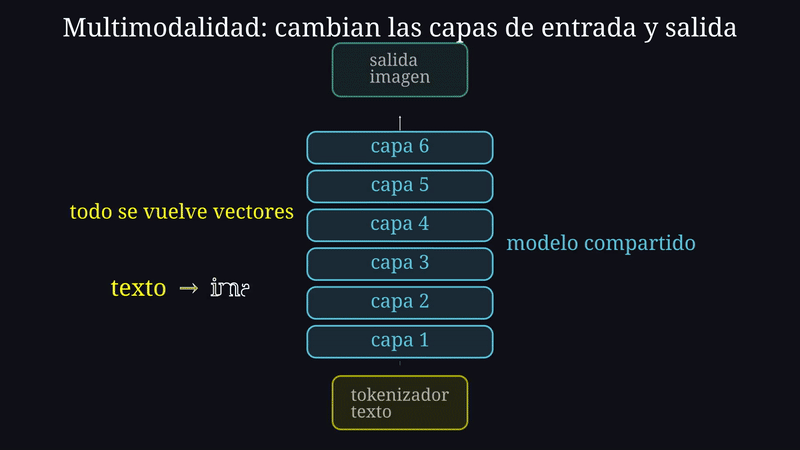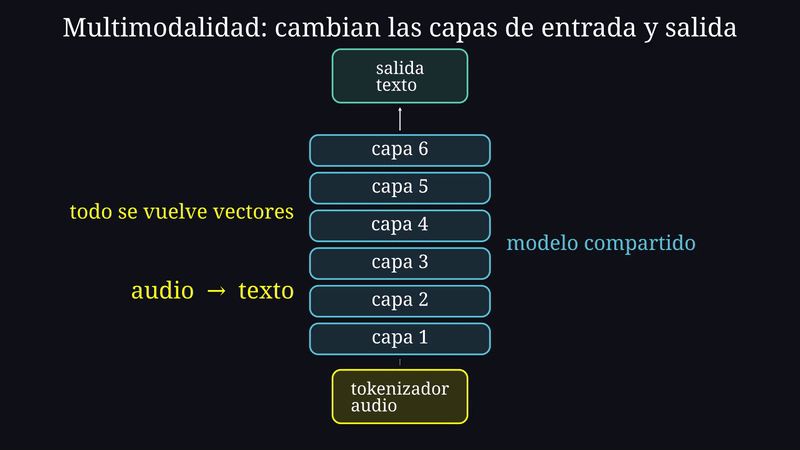
Abajo, cada modalidad cuenta con un tokenizador de entrada especializado que convierte texto, parches de imagen o segmentos de audio en vectores. En el centro, las capas del modelo compartido procesan todos esos vectores juntos. Arriba, la capa de salida (decoder) convierte los vectores resultantes en la modalidad que necesitamos entregar.
La capa de salida y el flujo completo en imagen
Cuando le pedimos al sistema que genere o edite una imagen, la operación ocurre en sentido inverso en el extremo superior: los vectores salen del modelo y la capa de salida los convierte en streaming, parche por parche, hasta armar la figura completa.
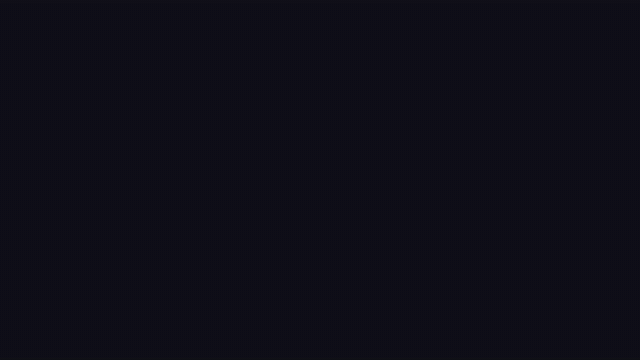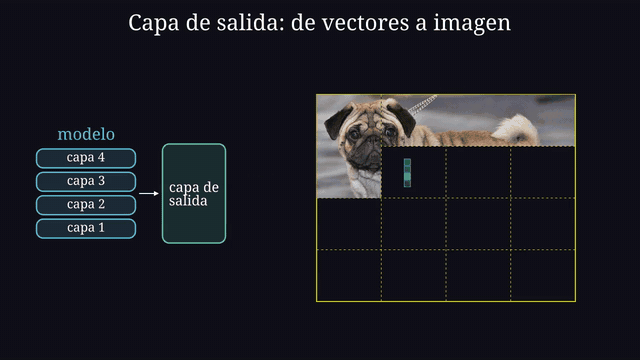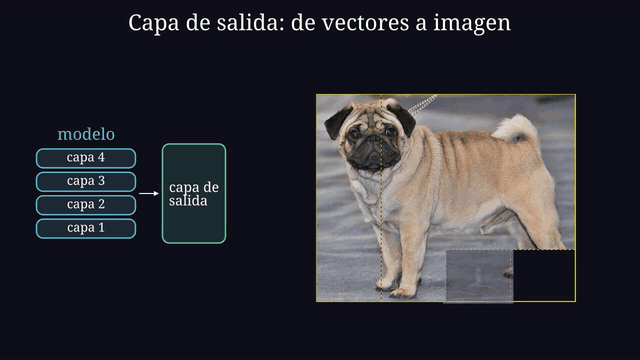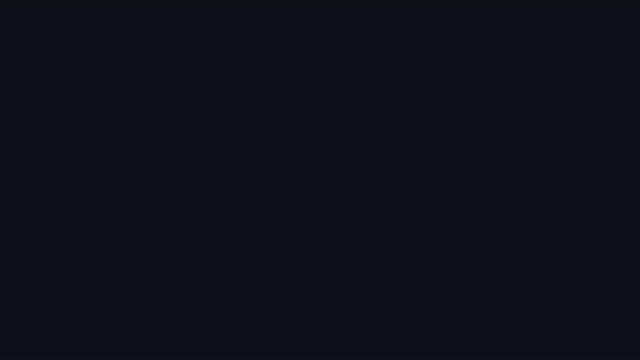
Al unir ambos extremos vemos el flujo completo en imagen: en la capa de entrada la foto se corta en parches, el modelo central procesa los vectores y la capa de salida reconstruye o genera la imagen parche por parche.
Qué entra y qué sale en imagen
Como el modelo central es compartido y solo cambian los extremos de entrada y salida, elegir la herramienta adecuada depende de qué entra como contexto y qué tiene que salir como resultado:
| Combinación | Qué entra y qué sale | Ejemplos prácticos |
|---|---|---|
| Imagen -> texto | Entra una fotografía o captura; sale una descripción, extracción o diagnóstico escrito. | Leer e interpretar un gráfico, describir un producto para un catálogo, revisar el pantallazo de un error. |
| Imagen + texto -> imagen | Entra una imagen base acompañada de una instrucción en texto; sale la imagen editada. | Retocar una fotografía, cambiar el fondo de una escena, sacar o modificar un elemento puntual. |
| Texto -> imagen | Entra únicamente una descripción escrita; sale una imagen generada desde cero. | Armar una sesión de fotos de producto sin cámara, crear el afiche visual de una campaña publicitaria. |
Audio: segmentos, capas y dos caminos para la voz
Si una fotografía se divide espacialmente en parches, ¿cómo procesa el modelo un sonido como el ladrido de nuestro pug o una grabación de voz? En el audio la dimensión que se corta es el tiempo: para el modelo, el audio es una secuencia de segmentos de tiempo convertidos en vectores.
Del sonido a los segmentos (capa de entrada)
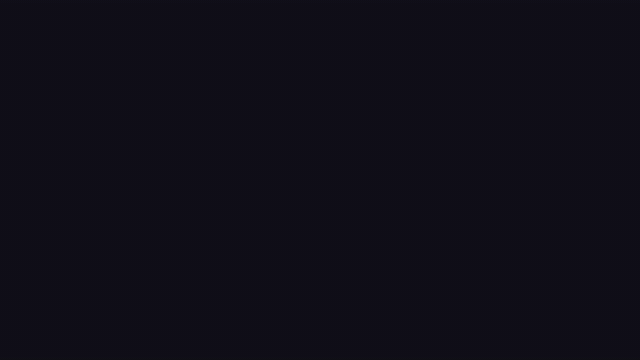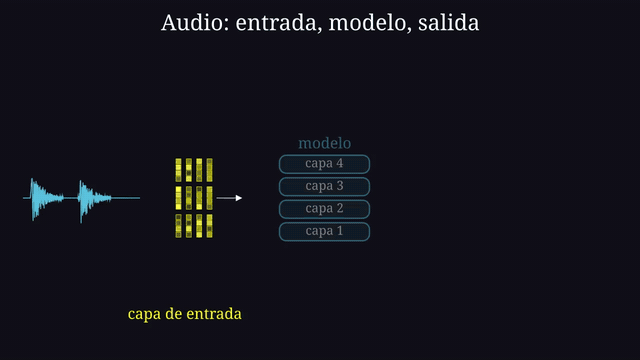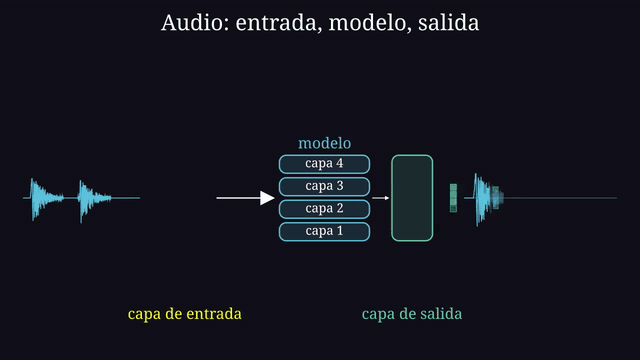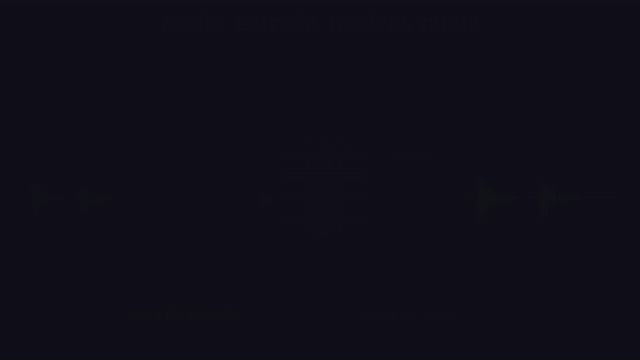
El tokenizador de audio toma la onda sonora (o su representación en frecuencias, el espectrograma) y la divide en pequeñas ventanas temporales. En el siguiente ejemplo simplificado, el ladrido se corta en 12 segmentos de tiempo que actúan como 12 tokens (en la práctica, un segundo de audio real se divide en decenas de segmentos):
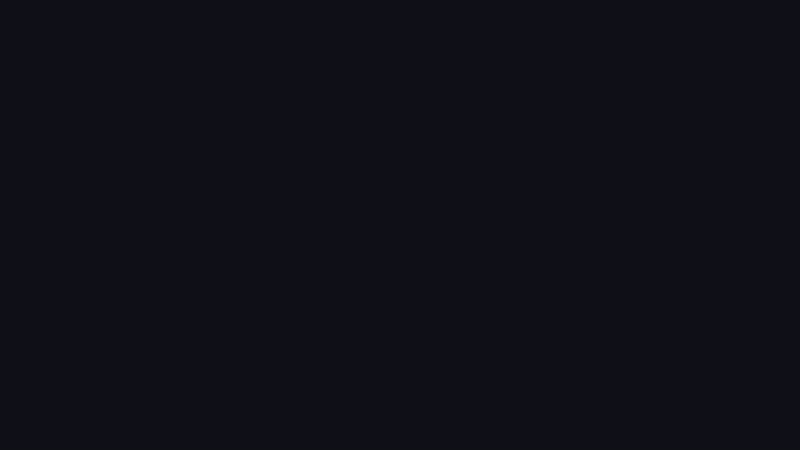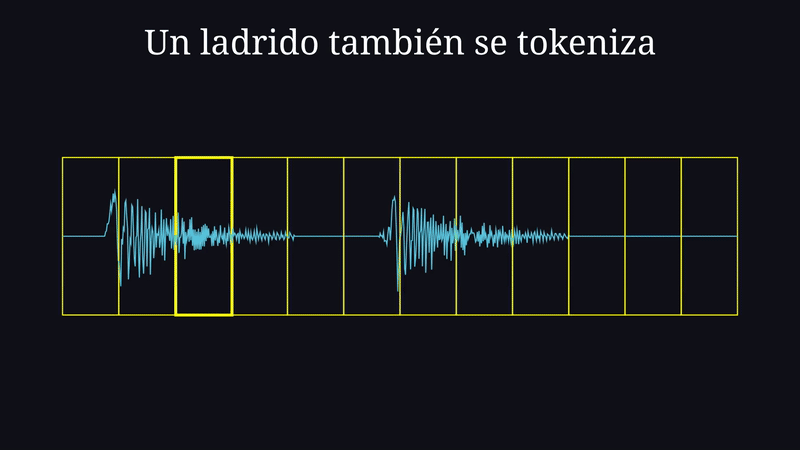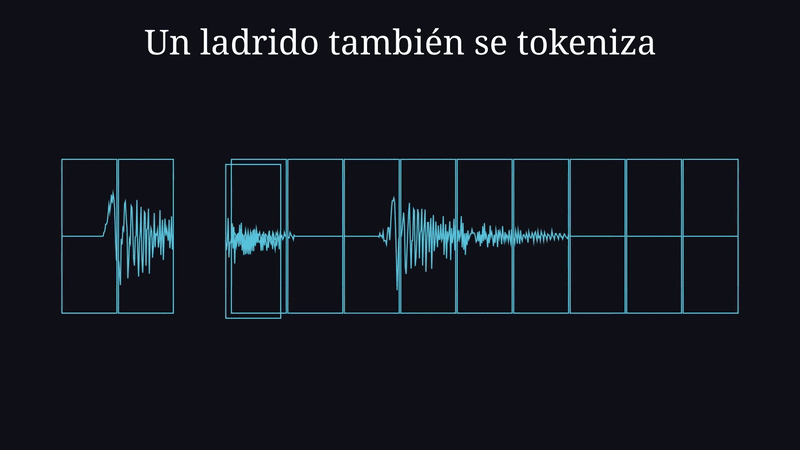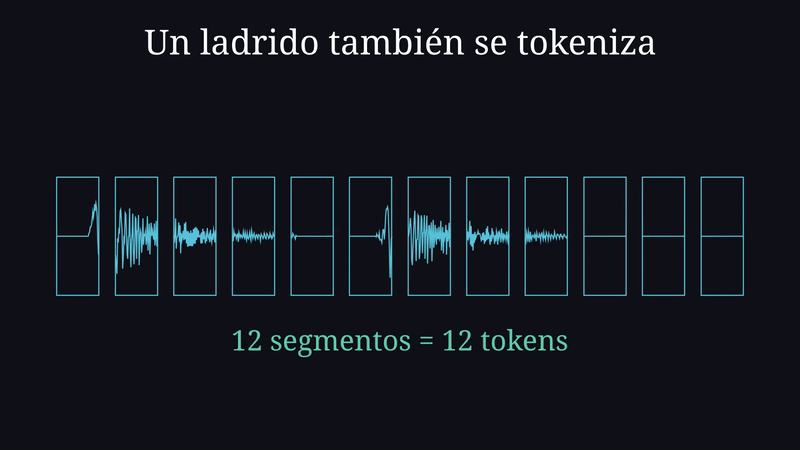
Una vez que cada segmento de tiempo se transforma en un vector, el recorrido por la arquitectura utiliza las mismas capas compartidas que vimos antes: entra audio por el tokenizador correspondiente, el modelo central procesa los vectores junto con las instrucciones y arriba puede salir texto (por ejemplo, una transcripción) o nuevo audio.
La capa de salida y el flujo completo en audio
Cuando el sistema debe responder hablando o generando sonido, los vectores salen del modelo y la capa de salida de audio los convierte en streaming, segmento por segmento, reconstruyendo la onda sonora de forma continua:
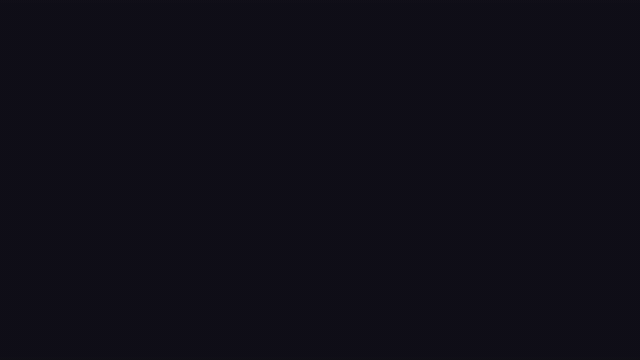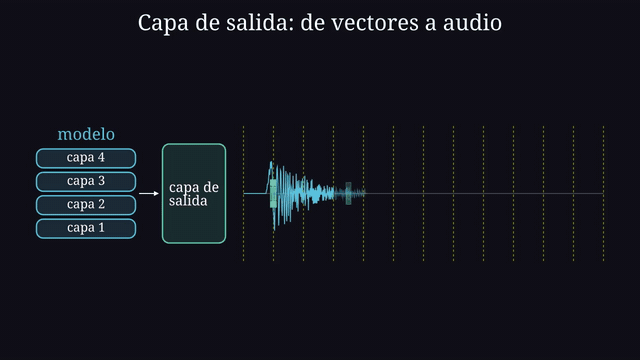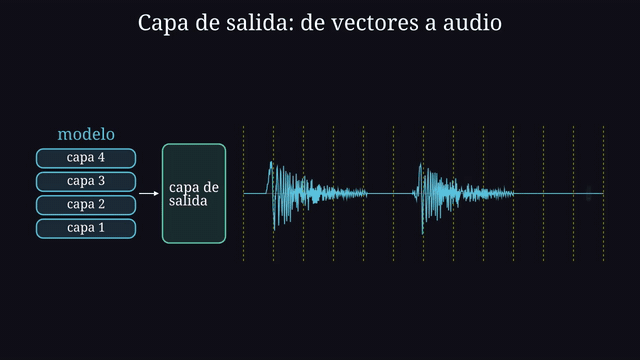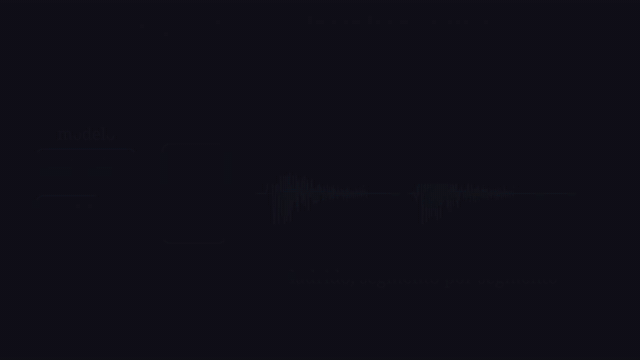
De punta a punta, el flujo completo en audio sigue la misma lógica unificada: entran segmentos de tiempo por la capa de entrada, el modelo procesa vectores en el centro y la capa de salida entrega la onda sonora.
Dos caminos para responder con voz
Cuando conversamos por voz con un asistente o construimos una aplicación hablada, existen dos arquitecturas distintas para ir desde lo que dice la persona hasta la respuesta en audio:
- Pasando por el texto (en cascada): primero un modelo transcribe la voz a texto (speech-to-text), luego el modelo de lenguaje redacta la respuesta en texto y finalmente un sintetizador (text-to-speech) lee ese texto en voz alta. Es un camino modular y fácil de auditar, pero suma la latencia de tres etapas y pierde matices como el tono emocional o el ritmo del hablante.
- De audio a audio (nativo): los segmentos de audio entran como vectores directamente al modelo multimodal y la capa de salida emite vectores de audio en streaming sin pasar por una transcripción intermedia. Gracias a eso responde mucho más rápido y conserva el tono, la prosodia y la expresividad de la conversación.
Qué entra y qué sale en audio
Al igual que en imagen, las herramientas de audio se organizan según qué modalidad entra al contexto y qué modalidad sale:
| Combinación | Qué entra y qué sale | Ejemplos prácticos |
|---|---|---|
| Texto -> audio | Entra un guion o apunte escrito; sale una pista de voz o locución sintetizada. | Generar un podcast de estudio desde los apuntes, producir una voz en off que lee un texto publicitario. |
| Audio + texto -> texto | Entra una grabación junto con una instrucción; sale un documento escrito. | Transcribir una entrevista completa, resumir los acuerdos de una reunión grabada siguiendo una pauta. |
| Audio + texto -> audio + texto | Entra voz e instrucciones; sale respuesta hablada en tiempo real (y su registro en texto). | Conversar con un asistente de voz interactivo, realizar el doblaje de una pista a otro idioma conservando la intención. |