Lectura completa
Consultar un manual y ubicar la respuesta
Tenemos el manual PDF de la Kodak PIXPRO FZ43 y queremos activar el temporizador. Además de conocer los pasos, necesitamos saber exactamente dónde aparecen en el manual para poder comprobarlos. Por eso pedimos la página y el título de la sección que respaldan la respuesta.
Un prompt para consultar el manual
Adjuntamos el PDF al agente y planteamos una pregunta concreta. La instrucción indica qué fuente consultar, qué respuesta entregar y cómo mostrar su ubicación.
Prompt para consultar el manual
Usa el manual adjunto de la Kodak PIXPRO FZ43 para responder:
¿Cómo activo el temporizador?

Explica los pasos en orden. Indica la página y el título de la
sección del manual que respaldan la respuesta. Si el manual no
contiene las instrucciones, dilo.
El prompt pide los pasos en orden y una referencia verificable. Con la página y la sección podemos abrir el PDF y revisar la explicación. Si el manual no contiene las instrucciones, esperamos que el agente lo diga.
De un manual a miles
Adjuntar y consultar un PDF puede servir para un manual, quizá dos. También tenemos el manual de la Kodak PIXPRO FZ151, que describe su propio procedimiento para usar el temporizador. En un catálogo con miles de cámaras y miles de manuales, cada respuesta debe encontrar el fragmento pertinente y conservar el modelo y la fuente a los que pertenece. ¿Cómo encontramos ese fragmento entre tantos PDF?
De palabras a vectores
Un vector es una lista ordenada de números. Como ejemplo pequeño, fijemos un diccionario de tres palabras en este orden: cámara, foto, temporizador. Cada posición contará cuántas veces aparece su palabra en un texto. "Cámara con temporizador" se convierte en [1, 0, 1], mientras que "foto foto" se convierte en [0, 2, 0].
La misma regla permite comparar textos porque cada posición mantiene el mismo significado. "La cámara toma una foto" produce [1, 1, 0]; "temporizador de la cámara", [1, 0, 1]; y "foto con temporizador", [0, 1, 1]. Este conteo es una representación didáctica, no un embedding aprendido por un modelo.
El conteo literal deja fuera relaciones entre expresiones. "Activa el temporizador" y "programa la cuenta regresiva" pueden referirse a la misma función aunque sus palabras no coincidan. Para buscar por significado necesitamos una representación que aprenda relaciones a partir de muchos textos.
Word2vec y los embeddings actuales
Word2vec aprende un vector para cada palabra observando las palabras que aparecen cerca de ella en muchos textos. Si cámara y celular aparecen en contextos parecidos, sus vectores pueden quedar próximos. El siguiente dibujo ilustra la idea; sus posiciones no provienen de un cálculo real de word2vec.
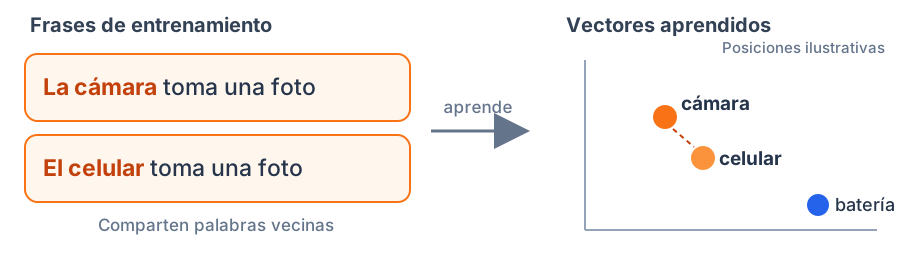
Un embedding es un vector numérico producido por un modelo para representar texto. Los modelos actuales pueden representar frases y fragmentos completos con muchos números. Conservamos la idea que necesitamos para esta clase: producir representaciones comparables para encontrar textos relacionados. Todos los vectores de ejemplo que siguen tienen números inventados.
¿Por qué importa?
Si representamos la pregunta y los fragmentos de los manuales con vectores comparables, podemos buscar textos relacionados aunque la pregunta use temporizador y el manual use autodisparador. Así evitamos revisar manual por manual cada vez que alguien consulta.
RAG: recuperar antes de responder
RAG significa Retrieval-Augmented Generation, o generación aumentada por recuperación. Primero se recupera información pertinente desde una fuente. Después el modelo usa ese texto como contexto para generar una respuesta. Aquí seguiremos una implementación frecuente: búsqueda de fragmentos mediante embeddings, manteniendo la referencia al documento original.
El recorrido tiene cuatro momentos: preparar documentos e indexar sus fragmentos; conectar una herramienta de búsqueda al agente; recuperar los fragmentos relacionados con la pregunta; y responder usando el texto y la fuente recibidos. En nuestro ejemplo, el modelo de cámara debe acompañar la respuesta para evitar mezclar instrucciones de FZ43 y FZ151.
Elegir y dividir las fuentes
Usaremos dos manuales PDF reales. En el de la FZ43, una sección sobre el autodisparador aparece en la página 33; en el de la FZ151, las instrucciones de temporizador aparecen en la página 35. Los dos tratan el mismo tema, pero describen controles propios de cada cámara. Guardamos el nombre del PDF y la página junto a cada fragmento.
Un manual completo contiene asuntos distintos. Lo dividimos en chunks: fragmentos de tamaño manejable que conservan el contexto necesario para entender una instrucción. Cada chunk mantiene el texto y su origen. Así, una coincidencia en el índice puede llevarnos de vuelta a la sección del manual.
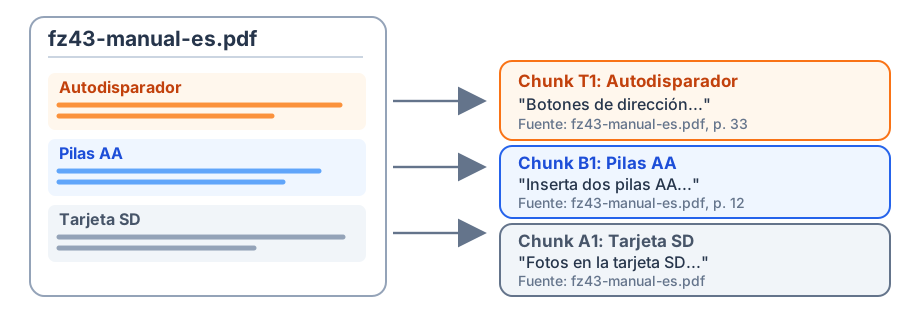
El corte importa. Si un chunk termina con "Para activar el temporizador..." y otro empieza con "...elige 10 segundos", la búsqueda podría traer solo media instrucción. Existen distintos algoritmos y procedimientos para dividir documentos en chunks; para este curso basta con comprender que esta división ocurre al preparar las fuentes y afecta el texto que recibe el agente.
Vectorizar e indexar
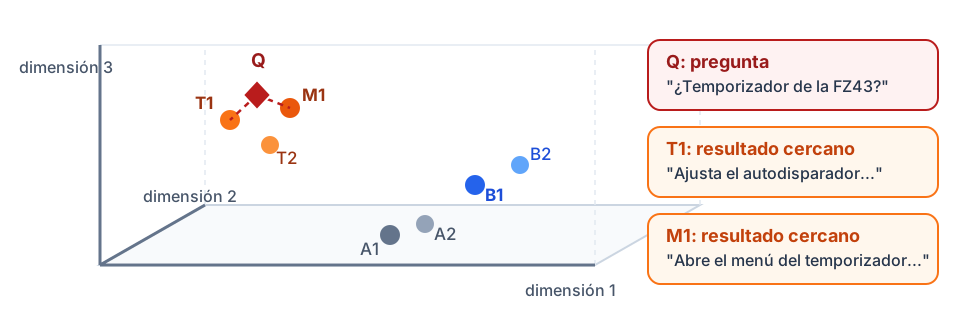
Un modelo de embeddings convierte cada chunk en un vector. El índice guarda ese vector junto al texto y su referencia. Imaginemos tres filas de una planilla: T1 guarda "FZ43: selecciona el autodisparador", el vector [0.82, 0.19, 0.63] y la referencia al PDF FZ43, página 33; B1 guarda "FZ43: inserta dos pilas AA", [0.15, 0.77, 0.28] y página 12; M1 guarda "FZ151: abre el menú del temporizador", [0.73, 0.21, 0.58] y página 35. Estos números son ilustrativos.
El vector facilita la búsqueda. El texto y la referencia permiten explicar y citar el resultado. Si solo guardáramos el vector, no tendríamos la instrucción original que el agente necesita para responder.
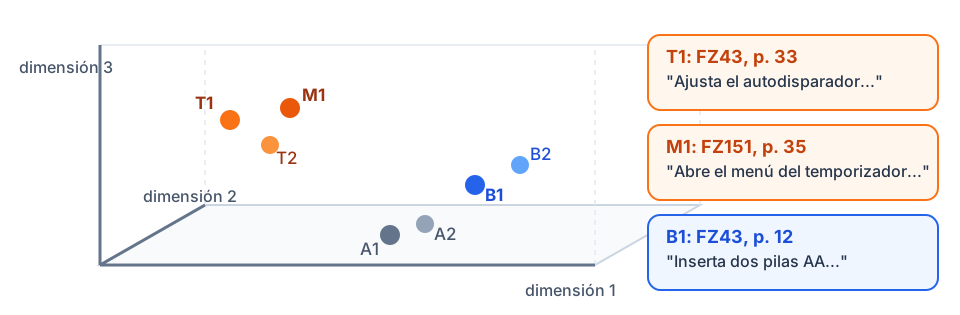
En el mapa, cada punto representa un chunk indexado. Los puntos cercanos sugieren fragmentos relacionados según el modelo. La figura muestra tres dimensiones para que podamos verla; los embeddings reales pueden tener muchas más.
Conectar la búsqueda al agente
El agente necesita una herramienta para consultar el índice. Recibe una pregunta en texto y devuelve chunks con sus referencias. En la actividad conectaremos una base de conocimiento de Meko con Copilot Studio mediante MCP; la herramienta de búsqueda se llama knowledgebase_search.
Recorrido de una consulta
Persona: "¿Cómo activo el temporizador de la FZ43?"
   Agente -> herramienta de búsqueda -> índice
   Agente <- fragmentos + origen  <- índice
Vectorizar la pregunta y buscar
La pregunta también se convierte en vector con el mismo modelo de embeddings que procesó los chunks. Usar representaciones comparables permite ubicar la consulta en el mismo espacio que los fragmentos indexados.
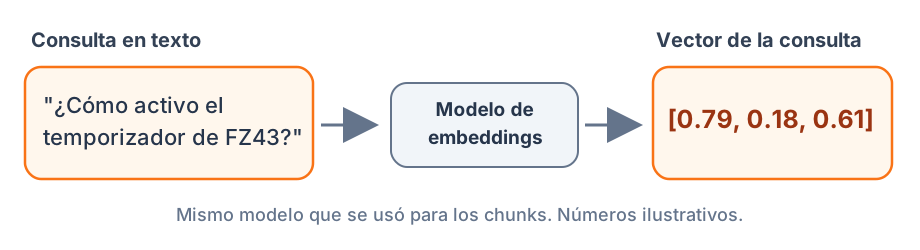
Una función de similitud ordena los puntos cercanos al vector de la pregunta. No necesitamos calcular distancias para entender la etapa: el sistema identifica candidatos relacionados y recupera el texto que estaba asociado a esos vectores.
Recuperar el texto y responder
La búsqueda puede traer la sección "Configuración/Ajustes del autodisparador" del manual FZ43, página 33. Antes de responder, verificamos que el fragmento sea de la cámara preguntada. Una respuesta posible explica que hay que pulsar el botón izquierdo, usar arriba o abajo para abrir el autodisparador, elegir 10 segundos con izquierda o derecha y confirmar; termina indicando "Fuente: manual FZ43, p. 33".
Si los manuales no incluyen el dato solicitado, el agente debe reconocer esa falta de información. La búsqueda puede devolver texto relacionado, pero la respuesta requiere comprobar que ese texto respalde lo dicho.
Decisiones de diseño
Al definir un RAG se eligen las fuentes, el tamaño de los chunks, el modelo de embeddings, la forma de indexar y la función de similitud. Algunos sistemas combinan búsqueda semántica y búsqueda por palabras. Estas decisiones cambian qué fragmentos aparecen. Aquí nos quedamos con el proceso completo: fuente -> chunks -> vectores -> búsqueda -> texto recuperado -> respuesta.
Actividad: un agente que consulta manuales de cámaras
Descarguen los PDF oficiales de la Kodak PIXPRO FZ43 y la FZ151. En Meko, creen una base de conocimiento con esos dos manuales. Después conecten el servidor MCP de Meko como herramienta de un agente en Copilot Studio y comprueben que aparece knowledgebase_search. El recorrido es: archivos -> Meko -> MCP -> agente.
En el chat de prueba, pregunten cómo activar el temporizador de la FZ43 y de la FZ151, qué tipo de pilas usa la FZ43 y cuánto cuesta hoy una FZ43 en Chile. Revisen si el agente llamó knowledgebase_search, qué fragmento obtuvo y qué fuente respalda cada respuesta. La pregunta por el precio actual sirve para observar qué hace cuando los manuales no entregan ese dato.