Lectura completa
Fundamentos
Unidad 1: qué hace un LLM, por qué alucina, y las capas modelo / asistente (con una mirada breve a agente). Modelos, límites y control humano.
Antes, hay que entender qué son
Las palabras “agente”, “AI” y “LLM” están muy de moda, y por ello se usan bastante, muchas veces de forma incorrecta.
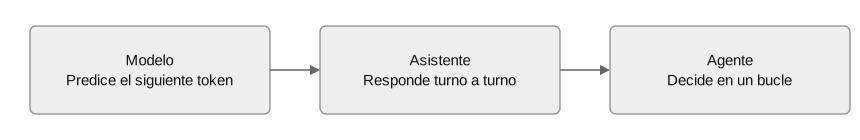
En esta lectura se apilan capas, de abajo hacia arriba:
- Modelo: predice el siguiente token.
- Asistente: responde turno a turno.
- Agente: decide en un bucle (lo veremos con más detalle más adelante en el curso).
¿Y qué entonces es IA?
La palabra IA se usa para casi todo: chatbots, recomendaciones, filtros de spam, robots, marketing... Es un concepto medio abusado.
Para efectos de este curso, cuando digamos IA nos referimos a:
Sistemas que producen respuestas o acciones útiles a partir de datos o instrucciones, sin que cada paso esté programado a mano.
En la práctica, vamos a trabajar sobre todo con modelos de lenguaje y con lo que se construye encima: asistentes y agentes.
Agenda de esta clase
- Modelo: pesos, tokens, alucinación, contexto (de entrada y de salida).
- De modelo a asistente: cómo aparece la conversación (prompt e historial).
- Actividad de verificación: auditar citas.
Modelo y límites
Partamos con lo simple
Si le preguntas a un chatbot “la capital de Chile es...”, responde “Santiago”. ¿Quién o qué te está respondiendo ahí, y cómo sabe?
En realidad, no es tan complejo:
- Por detrás hay lo que llamamos un “modelo”: eso es lo que genera la respuesta.
- La dinámica conversacional es más de lo que conocemos como un “asistente” (eso lo veremos más adelante en esta misma lectura).
- El modelo no piensa (o no al menos en la forma en que nosotros pensamos): no tiene memoria, no tiene intención, no tiene verificación.
Disclaimer
Lo que sigue es una vista muy de alto nivel de lo que hace un modelo.
Va a tener simplificaciones. El objetivo no es la ingeniería exacta, sino entender el funcionamiento de fondo: qué está pasando cuando “responde”.
Útil para operar y verificar. No es un curso de entrenamiento de redes neuronales.
¿Qué es un modelo (LLM)?
Un LLM (Large Language Model) es un modelo de lenguaje que predice la continuación más probable para un texto, a partir de un contexto inicial.
Un LLM predice la siguiente “palabra”
Imagina que recibes un pedazo de texto incompleto. ¿Crees que podrías completarlo? ¿Cómo?
Completa (en tu cuaderno o mentalmente):
París es una ciudad de _____
Varias continuaciones son factibles. Algunas alternativas:
- Francia (la más obvia)
- Texas (hay un París en Texas)
- la (de la región..., de la Belle Époque...)
- Europa
- arte (de arte y cultura...)
Respuesta de ejemplo: París es una ciudad de Europa donde se realizaron los juegos olímpicos el año 2024.
Eso ilustra lo que hace un LLM:
- Dado un texto, propone una continuación factible palabra a palabra.
- Esto se repite hasta completar el texto.
- No elige una sola palabra con certeza: asigna probabilidades.
Por eso la misma pregunta puede dar respuestas distintas.
Cómo funciona un LLM (video)
Video de apoyo: 3Blue1Brown - Large Language Models explained briefly.
El ciclo del entrenamiento
Dado un texto, se oculta la última palabra y el modelo predice.
Se compara la predicción del modelo con la palabra real. A mayor error, más se ajustan los pesos.
¿Qué son los pesos?
Números que el entrenamiento ajusta poco a poco a partir de miles de ejemplos.
En el entrenamiento, se ajustan los pesos billones de veces, hasta completar texto nuevo en una forma que haga sentido.
Si los pesos son numéricos, ¿cómo se conectan con el texto? ¿Cómo operan entre ellos? La respuesta pasa por los tokens.
Tokens: la conexión entre pesos y texto
El modelo predice el siguiente token
- Parte la entrada (input) en tokens (palabra, trozo o signo).
- Los tokens se convierten en números para entregarse al modelo en forma de lista de números.
- Se elige el siguiente token y se agrega al contexto.
- Se repite el proceso con el nuevo contexto (entrada + nuevo token).
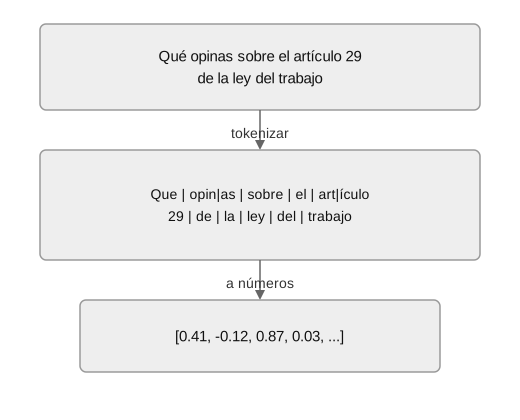
La tokenización no siempre es división por palabras ni por espacios. Algunas palabras se parten, algunas se juntan, otras se ignoran.
Actividad: tokenizer
Ejercicio práctico: prueba el tokenizer de OpenAI en https://platform.openai.com/tokenizer
Observa cómo un mismo texto se parte en unidades que no siempre coinciden con “palabras”.
Otro ejemplo de generación en vivo: TokenProbe (Columbia) - Visualizing LLM Learning in Real-Time: https://tokenprobe.cs.columbia.edu/
¿Y qué es el contexto?
En un LLM, el contexto es todo lo que el modelo tiene a la vista en ese instante para predecir el siguiente token: la instrucción que le entregaste y lo que ya escribió en la misma respuesta.
Es un tamaño limitado (medido en tokens): lo que no entra en ese tamaño, el modelo no lo puede usar para decidir.
Durante el curso vamos a hablar mucho de contexto. Según el tema (modelo, prompt, documentos, conversación, agente...), la palabra apunta a algo parecido, pero no siempre es exactamente lo mismo.
Lo importante a recordar
- Entrenamiento: ajustar pesos con ejemplos.
- Tokenización: dividir y convertir a números.
- Contexto en LLMs: lo que el modelo puede ver y usar para predecir.
Frontera irregular (jagged frontier)
¿Qué debería ser más fácil: resumir un párrafo, o contar cuántas “r” hay en strawberry?
Los modelos fallan en tareas que parecen triviales porque no “cuentan” letras. Trabajan con tokens, no con caracteres: strawberry no se ve como s-t-r-a-w-b-e-r-r-y, sino como trozos que ya vienen armados y, por tanto, simplemente adivinan.
Los modelos no son inteligentes de la forma en que nosotros pensamos
- Capacidades altas en tareas que a nosotros nos parecen difíciles.
- Fallas en otras que nos parecen triviales.
- Los modelos están diseñados para generar respuestas que suenen legítimas.
Por eso siempre es importante verificar la respuesta del modelo.
Alucinación y verificación
Si inventa una cita a un paper, ¿está “mintiendo”?
No en el sentido humano de mentir. El modelo completa un patrón que suena legítimo.
Alucinación
- El modelo completa un patrón que suena legítimo.
- En el entrenamiento predice el siguiente token a partir de texto visto.
- Datos raros (una cita, una fecha) dejan poca señal: inventar y acertar pueden sonar igual de bien.
- Si se evalúa solo por “acertó / falló”, adivinar gana al “no sé”.
Alucinar es rellenar con fluidez cuando falta contexto para predecir.
Cómo evitamos la alucinación
Verificando la respuesta.
Si el modelo cita un paper, búscalo por título o su identificador. Si da un número, contrástalo con la fuente original o con otra búsqueda.
Más adelante en el curso veremos cómo verificar la respuesta de manera sistemática.
Actividad: auditar citas
En un solo chat de LLM Arena (https://lmarena.ai) — Direct Chat, sin búsqueda web — corre estas preguntas. Luego verifica cada cita: ¿existe? ¿el detalle cuadra?
Derecho
Cita tres fallos de la Corte Suprema de Chile (rol, año y sala y enlace a la sentencia) sobre responsabilidad civil por daños causados por sistemas de inteligencia artificial. Incluye una cita textual de cada fallo.Medicina veterinaria
Dame la cita completa y el DOI de Contreras et al. (2023), Efficacy of ivermectin nanoemulsion against canine demodicosis in Chile, en Veterinary ParasitologyHistoria
Dame la cita completa (archivo, fondo, volumen y foja) de tres documentos del Archivo Nacional Histórico de Chile que prueben que Bernardo O'Higgins prohibió las imprentas privadas en 1818. Incluye una transcripción textual de cada uno.De modelo a asistente
Manejo de conversación
En el ejercicio anterior, el modelo ya no era solo una entrada y una salida: se maneja como una conversación. Ahí aparece la diferencia entre el modelo y el asistente.
- El modelo recibe una entrada y genera una salida. Cada llamada es independiente.
- El asistente recibe una entrada, genera una salida y puede recibir una nueva entrada.
- El modelo no “recuerda” turnos anteriores por sí solo. En cada iteración es una nueva conversación.
- El asistente arma el contexto con el historial de la conversación.
- El modelo solo predice texto plausible a partir de lo que recibe como entrada.
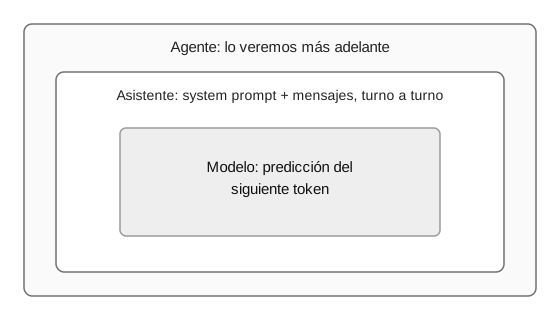
Cuando abren ChatGPT, Claude o Copilot, ¿usan el modelo o un asistente? Ambos: el modelo es la capa más baja; sobre eso se construye el asistente. El agente (decide en un bucle) aparece como capa siguiente y se profundiza más adelante.
Cada capa es una abstracción mayor
El modelo es la capa más baja (en la que comienza el curso). Es el que predice el siguiente token. Sobre eso se construye el asistente. El agente queda para más adelante.
1. Modelo
Motor de predicción. Texto entra → continuidad plausible sale.
Puede proponer una herramienta a usar; no la ejecuta.
2. Asistente
Producto conversacional sobre un modelo: una prompt inicial + historial de mensajes (asistente y usuario).
Patrón turno a turno: tú pides → responde → tú decides el siguiente paso.
¿Qué es un prompt?
El texto de entrada que le das al asistente en un turno: una pregunta, una instrucción o un ejemplo.
Ejemplo en un chat: después de un saludo y un par de turnos, el mensaje que envías (“Explica qué es un token en una frase, con un ejemplo”) es el prompt de ese turno.
¿Qué es el historial de conversación?
La secuencia de mensajes (tuyos y del asistente) que el producto vuelve a incluir en cada nuevo turno.
El modelo no “recuerda”: el asistente reenvía ese arreglo de textos como parte del contexto.
Con estas dos cosas combinadas
Lo que el asistente le envía al modelo es una lista de mensajes con roles; el modelo genera el siguiente mensaje del asistente:
[
  { "role": "assistant", "content": "Hola. ¿En qué te ayudo?" },
  { "role": "user", "content": "¿Qué es un token?" },
  { "role": "assistant", "content": "Una unidad de texto que el modelo procesa." },
  { "role": "user", "content": "Explica qué es un token en una frase, con un ejemplo." }
]
Y lo que el modelo genera es, por ejemplo:
{ "role": "assistant", "content": "Un token es una unidad de texto; por ejemplo, \"Chile\" suele ser un solo token." }